Loading
|
|
@IT|@IT自分戦略研究所|QA@IT|イベントカレンダー+ログ |
|
Loading
|
| @IT > SPSS事例探求 第10回 日経BPコンサルティング編 |
 |
企画・制作:アットマーク・アイティ
営業企画局 掲載内容有効期限:2003年7月31日 |
|
|
|
近年、商品・サービスの均質化が進み、製品の機能や性能などを訴求するだけでは、もはや競合他社に差をつけることが難しくなってきている。そうした中で、企業の業績に大きな影響を与えるキーワードとして、企業や製品のもつ「ブランド」に対する関心が高まっている。「ブランド」といっても、海外の高級品のことではない。 例えば、「ソニー」「VAIO」「ディズニー」「UNIQLO」など、企業名そのものやその企業の製品名がユーザーに与える「信頼できる」「革新的」「親しみやすい」といった“好感度”や製品を選択する際の基準ともなる“プラスイメージ”を伴った名称のことである。この一朝一夕で構築することはできない「ブランド」が、企業の競争優位性を確保する貴重な経営資産の1つとして認知されている。 今回は、日経BPコンサルティングが実施したブランドイメージ調査「ブランド・ジャパン2003」において、SPSSと協力し、自由回答データをテキストマイニングするという新しい試みについて詳しく話を聞くことができた。取材にご協力いただいたのは、日経BPコンサルティング 調査第二部 課長 齋藤訓之氏である。
「ブランド・ジャパン」は、ノミネートブランド数のべ1500、調査対象者数3万8000人という最大規模を誇る調査として、日経BPコンサルティングが2001年から年1回実施。調査結果は報告書としてまとめられ、100以上の企業・団体・研究機関などで活用されており、もっとも信頼性の高いブランド評価の1つとして認知されている。2003年4月には、最新レポート「ブランド・ジャパン2003」が発表された。
「ブランド・ジャパン」の調査は、大きく2つに分けられている。1つは、一般消費者にブランドを評価してもらうコンシューマー市場(BtoC)編で、郵送法、およびインターネット調査を並行して実施。もう1つは、ビジネスパーソンにビジネスという観点でブランドを評価してもらうビジネス市場(BtoB)編で、こちらはインターネット調査のみを実施するというものである。 「ブランド・ジャパン2003」では、BtoC調査で約1000ブランド、BtoBでは約500ブランドを対象として、大規模な調査が行われた。ちなみに、BtoC市場における上位3位は、「1位:ソニー」「2位:ディズニー」「3位:フジテレビ」であった。また、BtoB市場においては「1位:ソニー」「2位:ホンダ」「3位:トヨタ自動車」という結果が出ている。
「ブランド・ジャパン」では、公正で高度な評価・分析を行うために、東京大学経済学部教授 片平秀貴氏が委員長を務める、ブランド・マーケティング・統計学の専門家集団「ブランド・ジャパン企画委員会」を設置している。そして、“共分散構造分析(*)”という高度な分析手法を活用して、ブランドの総合力を決める要因(因子指数)を特定し、モデル化していること点が特徴といえる。 ブランド・ジャパンが実施する“共分散構造分析”では、BtoC編においては「フレンドリー(親しみ)」「イノベーティブ(革新)」「アウトスタンディング(卓越)」「コンビニエント(便利)」という4つの潜在変数、BtoB編においては「親和力」「信用力」「活力」「先見力」「人材力」という5つの潜在変数を伴う仮説を立て、これにしたがって、調査を設計、分析を行うという独自の調査手法を確立している。
齋藤氏は、このモデル化されたブランド評価パス図の意義を次のように語る。
「ブランド価値を得点化できる一方、1つのブランドについてブランド価値の構造をこのモデルで明快に示すことができるので、ユーザーからは、『理解しやすい』『自社ブランドのどこに問題があるかが、明確にわかる』といった評価をいただいています」 しかし、齋藤氏によれば、調査を重ねるにつれ、ユーザーの意見・要望は明らかに変化してきている、という。
「前回までは、総合力が何点で順位は何位であり、その原因としては、この因子指数がこうだったからです、といった説明で、お客様はほぼ満足されていました。ところが、2回目の調査結果に対しては、『イメージを向上するためには、具体的にどうしたらいいのか』『PRには注力してきたつもりだったのに、なぜ、こんな低い結果になるのかわからない』といった、より深い分析を必要とするような質問や意見が多くなってきました」
こうしたユーザーの声は第2回までにもいくつか寄せられており、今後より多くのユーザーからも同様の声が寄せられることが予測されたため、何らかの新たな分析手法への取り組みが必要だ、と感じるようになったという。 そこで、「ブランド・ジャパン 2003」の調査では、インターネット調査の回答フォームに、新たに自由回答欄を設けたそうだ。選択肢から回答を選ぶだけでなく、自由に記述してもらうことによって、回答者の生の声という定性的なデータを収集し、報告書に添付するCD-ROMに収録した。ただし、今回はテキストマイニングの結果を報告書に盛り込んではいない。試験的に自由回答データの分析を行い、今後のテキストマイニング活用の可能性を探ることが目的だったということだ。 実際の分析作業においては、SPSSの「Text Mining for Clementine」というツールを用いたテキストマイニング全般に関わるコンサルティングとして、SPSSからの全面的な協力を得たという。齋藤氏と共同で分析作業を進めたのは、SPSS プロフェッショナルサービスグループ シニアコンサルタント 川嶋敦子氏である。川嶋氏は、テキストマイニングによる分析を用いた博士論文を提出、情報コミュニケーションの博士号を有する、いわば、テキストマイニングの実践経験者である。
自由回答データを分析するためには、まず、文章を「コンセプト」単位まで細分化する必要がある。コンセプトとは、意味のあるレベルで単語を括ったものであり、このコンセプトを抽出できる点が「Text Mining for Clementine」のもっとも優れた機能の1つである。 文章を分解する手法としては、形態素解析というやり方もある。しかし、これは、文章を最小の単位である「品詞」にまで分けてしまうため、「品詞」1つ1つから、まとまった意味を汲み取ることは困難である。例えば、形態素解析ツールである「茶筌」と「Text Mining For Clementine」で同一の文章を解析した場合の結果を比べてみよう。
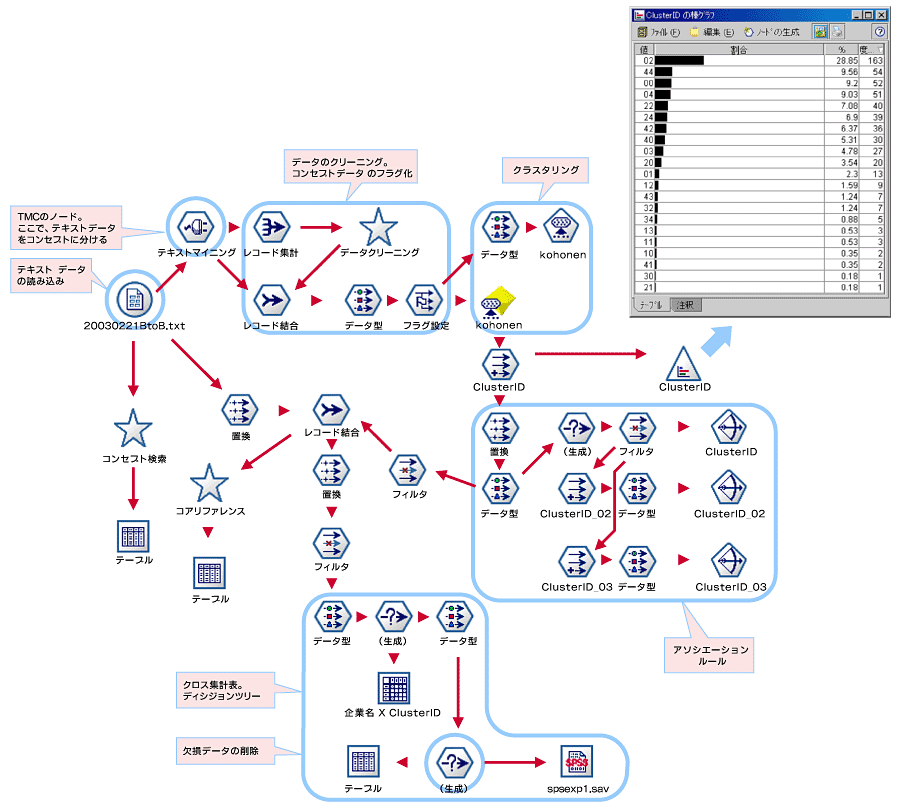
「茶筌」では、「苦いビール」というフレーズが「苦い」と「ビール」という2つの単語に分解されてしまうため、本来伝えたい「にがみのあるビール」という意味を1つ1つの単語だけから判断することは難しくなってしまう。しかし、「Text Mining For Clementine」であれば、「苦いビール」というひとくくりの単語に分解されるので、それだけで十分意味が通じる。このことからだけでも、コンセプト抽出がテキストマイニングにおいて、いかに重要な機能かがお分かりいただけるだろう。 SPSSのClementineには、CEMI(Clementine External Module Interface)の機能を活用してテキストマイニングツール「Text Mining for Clementine」のノードを組み込むことができる。また、「茶筌」をインストールし、同じくCEMIを使って「茶筌」を「Clementine」のノードとして組み込むことも可能だ。そして、グラフィカルで使いやすい「Clementine」上で、目的に応じて両者を自由自在に使い分けながら分析を進めることができる。今回の分析では、「茶筌」による形態素解析により、自由回答データの総単語数や動詞、副詞、形容詞など、各品詞の出現頻度数などの基本的な分析を行い、さらに「Text Mining For Clementine」によるコンセプト抽出によって、分析精度を高めたそうだ。 文章からコンセプトを抽出したのち、1回しか出現しない単語や、分析に値しないと思われる不要なデータを排除する、データクリーニングを完了すれば、通常の定量データの分析と同様に「Clementine」上でさまざまなデータマイニングを容易に行うことができる。しかし、分析結果を得た後であっても、分析プロセスをさかのぼり、データクリーニングからやり直すこともよくあるらしい。この点について、川嶋氏は今回の分析を振り返って次のように話してくれた。 「今回の分析では、分析結果を眺め、このコンセプトを除外したらどうなるかと仮説を立てて、データクリーニングからやり直す、という分析プロセスを繰り返し行うことによって、分析結果の精度が大きく向上していきました。“Clementine”の場合、『ストリーム』という目に見える形で分析ロジックを追うことができますし、各ノードでどんな作業を行ったのかをいつでも確認することができます。したがって、試行錯誤的に分析プロセスを繰り返す場合でも、過去の作業内容を確認しながら進めることができ、効率的に分析を進めることができました」 分析プロセスそのものを目に見える形で保存するという「Clementine」の特徴については、齋藤氏も高く評価しているようだ。共同で作業を進めるにあたって、川嶋氏がどのようなロジックで分析を進め、具体的にどのような作業を行ったのかを確かめながら、理解することができたという。
今回の分析では、Kohonenネットワーク(**)によるクラスタリングを行い、以下のようなクラスタを得た。
さて、それぞれのクラスタに与えられた名称を眺めてみて欲しい。察しのよい方であれば、すでにお気づきかもしれないが、既出のBtoB編のブランド評価パス図をほうふつさせるものであるといえるだろう。つまり、今回のテキストマイニングによる自由回答データ分析の結果により、「ブランド・ジャパン」が活用しているブランド価値の構造モデル「ブランド評価パス図」の妥当性が検証できたと言い換えることができる。
データマイニングにおいて一般的な法則を導こうとする場合、往々にして小数意見は排除される傾向にある。今回試みられたテキストマイニングでも、このような処理方法は定石で、自由回答データからコンセプトを抽出し、データクリーニングを行う際に、1回しか出現しない単語は除外したそうだ。 しかし、こうした低頻度単語について、川嶋氏は意外な発見をしたという。さまざまな低頻度単語で形容されたブランドがあるかと思えば、低頻度単語がそれほど出現しないブランドがあったというのだ。川嶋氏は、この点について次のように語る。
「さまざまな言葉で形容されているブランドは、同じような言葉で語られているブランドと比較すれば、より多様な評価を受けている、つまり『話題性』を持っていると考えられるのではないでしょうか。したがって、低頻度の単語量に着目し、『異なり語』がどのくらい含まれるかということを調べることによって、例えば、ブランドの『話題性』を測ることができるかもしれません。具体性・多様性を示す指標として、低頻度語の分析手法を確立していければと考えています」 一方、齋藤氏は今回の分析を通じ、ブランド評価調査にテキストマイニングを活用することへの可能性を強く実感したようだ。「ブランド・ジャパン」の自由回答を対象としたテキストマイニングは、定量的な調査・分析の有効性を裏付けることができただけでなく、自由回答データであるがゆえの新たな知見を得ることができた。そうした知見を膨大な自由回答から見出すために力になってくれるのが、「Clementine」であり、「Text Mining for Clementine」である。そして、SPSSでは分析ツールの提供だけでなく、新たな分析手法を試みようとする企業へのサポートについても、積極的に取り組んでいる。次年度の「ブランド・ジャパン 2004」では、テキストマイニングによるブランド評価結果がまとめられ、報告されることを期待したい。
|
|
|||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||