
【Pythonで学ぶデータ分析】PyMC早わかり ~ PyMCのモデルを可視化する:やさしい推測統計(ベイズ統計編)
PyMCはベイズ統計に欠かせないMCMCサンプリングのためのライブラリ。これまではさまざまな推定や検定を行うために、使い方を中心に見てきました。今回はPyMCそのものの仕組みについて見ていきます。『社会人1年生から学ぶ、やさしいデータ分析』ベイズ統計編、番外編(第10回)です。
PyMCの仕組みってどうなってるの? 連載『社会人1年生から学ぶ、やさしいデータ分析』のベイズ統計編、第10回となる今回は、PyMCの仕組みに少しばかり踏み込むためにモデルの可視化を行います。また、事前分布や尤度(ゆうど)関数の定義によって作成される計算グラフがどのようなものであるかを解説します。いずれも余りに奥が深いので、お話するのはほんの入り口だけになりますが、PyMCによるモデリングがある程度納得してできるようになるかと思います。
この連載では、簡単な事例を通してベイズ統計の考え方と分析の進め方を解説します。新しい用語や考え方が幾つも出てきますが、全てを理解しなくても大丈夫です。登場するたびに、分かりやすく丁寧に説明するので、その時点で分からないことがあっても気にせず、先に進んでください。回を追うごとに、少しずつ理解が深まります。どんな考え方で、どんな手順で分析を進めるのか、といった大きな流れを捉えてください。
連載:

この連載では、データをさまざまな角度から分析し、その背後にある有益な情報を取り出す方法を学ぶ『社会人1年生から学ぶ、やさしいデータ分析』シリーズの「記述統計と回帰分析編」「確率分布編」「推測統計(区間推定編・仮説検定編)」に続く「ベイズ統計編」です。
これまでの推測統計を土台に、近年活用が広がっているベイズ統計の考え方と分析手順を、古典的な手法との違いを整理しながら解説します。初めての方でも無理なく理解できるよう具体例を通して進めるとともに、ベイズ的なアプローチの特徴やメリットを実感できる構成とし、「どのように考え、どう使い分けるのか」に重点を置いて解説していきます。

筆者紹介: IT系ライターの傍ら、かつて、非常勤講師として東大で情報・プログラミング関連の授業を、一橋大でAI関連の授業を担当。まだ発展途上のようだが、生成AIへの質問と回答を分野ごとにまとめ、体系的に整理、補足しつつ、さらに個別の学びを促す記述を加えた資料を一貫して作成できるツールが実用レベルで本格的に使えるようになると、書籍の概念が変わるのではないかと思ったりしている。一斉授業だったものが、ユーザーに合った個別指導のできる書籍といったイメージ。そうなると、出版社のビジネスモデルも大きく変わり、私の仕事もなくなってしまいそうだけど、まあ、そのときは、縁側でお茶でもすすりながら、庭の景色を眺めて暮らすことにしようと思う。ウチには縁側も庭もないけど。
そもそもPyMCって何?
これまで、ベイズ統計のモデリングやサンプリングを行うために、当然のようにPyMCライブラリのモジュールを利用してきました。今回は、そもそもPyMCとは、というところからおさらいし、続いてモデルを可視化する方法、計算グラフの意味や取り扱い方を見ていきます。また、サンプリングの際に使われる自動微分についても紹介します。
まず、PyMCの簡単なおさらいです。ベイズ統計では、共役事前分布を利用すると、事後分布のパラメーターが解析的に(数式の計算で)求められます。しかし、モデルが複雑になったり、共役事前分布が使えない場合には、解析的な計算が難しくなります。そのような場合、マルコフ連鎖モンテカルロ法(MCMC)などにより、事後分布のサンプルをシミュレーションで求めるという方法がよく使われます。
そのためのモデルをPythonで記述したり、サンプリングを行ったりするためのツールがPyMCです。それにより得られたサンプルを基に、平均や信用区間などを推定する、というわけです。

サンプリングのために使われるマルコフ連鎖モンテカルロ法のうちのメトロポリス法については、『数学×Pythonプログラミング入門』の第7回で取り上げましたが、PyMCで標準的に使われているのはマルコフ連鎖モンテカルロ法の一種であるハミルトニアンモンテカルロ法を拡張したNUTS(No-U-Turn Sampler)と呼ばれるアルゴリズムです。
PyMCでモデルを記述する方法は、基本的には事前分布と尤度関数を定義するだけです。すると、それぞれの確率変数が計算グラフ(計算のルールのようなもの)のノードとして登録されます。また、確率変数同士の依存関係が自動的に構築されます。概念だけを先に出してしまうと実感が湧きにくいので、ここから変数同士の依存関係や計算グラフが具体的にどのようなものであるかを少しずつ見ていきましょう(図1)。

図1 PyMCのモデルと計算グラフを可視化する
今回の目的はモデルの構造を可視化して解きほぐし、さらに計算グラフがどのようなものであるかを確認すること。モデルの構造(図の中央)についてはなんとなく意味が分かるはず。計算グラフ(図の下のリスト:muについて表示したもの)は少し分かりにくいかもしれない(詳細は後述)。
それでは、PyMCのモデルを可視化するところから見ていきましょう。
PyMCのモデルを可視化する
最初にモデルの構造を可視化するためのコードを書いてみましょう。事例は図1に示したようなものとします。つまり、事前分布として、標準偏差がsigma=1の半正規分布に従い、平均が標準正規分布(mu=0, sigma=1)に従うものとします。また、尤度関数が平均mu、標準偏差sigmaであるものとします。観測データはxです。以下のリスト1がモデル定義と可視化のためのコードです。実際に試してみるには、サンプルファイルを開いてみてください。Google Colaboratoryの画面が表示されるので、最初のコードセルをクリックして[Shift]+[Enter]キーを押せば実行できます。
import numpy as np
import pymc as pm
x = np.array([ 0.80, -0.66, 1.01, 0.34, 0.80 ,
-0.75, -0.74, 0.47, -0.83, -0.35])
with pm.Model() as model:
sigma = pm.HalfNormal("sigma", sigma=1)
mu = pm.Normal("mu", mu=0, sigma=1)
obs = pm.Normal("obs", mu=mu, sigma=sigma, observed=x)
# モデルの構造を見るだけなので、実際のサンプリングは行わない
dot = pm.model_to_graphviz(model) # graphvizのグラフを作成する
dot # グラフを表示する
モデルの作成については、これまでの知識で十分理解できるはず。pm.Model()は、確率変数や尤度関数を定義するための「入れ物」を作るものと考えればよい。事前分布の確率変数としてsigma、muを定義し、尤度関数としてobsを定義している。pymc.model_to_graphviz関数を利用すれば、Graphvizと呼ばれる可視化ツールのグラフが作成できる。ここでは、モデルを定義して可視化しただけで、サンプリングは行っていない。
リスト1で定義したモデルに含まれる事前分布の確率変数や尤度関数の依存関係(モデルの構造)を、pymc.model_to_graphviz関数で可視化した結果が図1の中央のグラフです。その部分を色分けし、説明を加えて再掲しておきます(図2)。

図2 可視化されたモデルの構造
楕円で描かれたノード(上の2つ)が事前分布の確率変数の定義、角丸の四角が観測値を含むノードを表している。そのノードの中に(尤度関数の)確率変数のノードがある、といったイメージ。図中の「mu」「sigma」「obs」は、pymc.Normalクラスやpymc.HalfNormalクラスの第1引数に指定した名前。角丸の四角の右下にある10という値は観測値の個数。
可視化されたモデルについては、これまでに見てきたベイズ更新のための式と対応しているので、それほど難しくはないでしょう。
ここでの「グラフ」とは、棒グラフや折れ線グラフではなく、ノード(頂点)とエッジ(辺)からなる図のことです(念のため)。図1や図2ではノードが楕円で描かれ、エッジが矢印で描かれています。
なお、図2の上に記したベイズ更新の式では、パラメーターをθで代表させていますが、リスト1の例ではパラメーターがμとσの2つなので、具体的には以下のように表されます(おさらいです)。つまり、
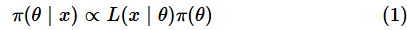
のθに、μとσを当てはめた
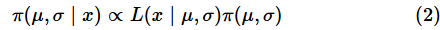
ということです。
自動微分で勾配を求めてみる
実際のサンプリング(NUTS)では、このL(x | μ, σ) π(μ, σ)という式に基づき、勾配(微分係数)を求め、密度の高い領域のサンプルを多く取り出し、密度の低い領域のサンプルは少なく取り出されるようにしています。ただし、そのアルゴリズムはかなり複雑なので、ここでは割愛します。確率モデルを定義し、(上のリストには書いていませんが)pymc.sample関数を呼び出せば、自動的にサンプリングが行われるということになります。
PyMCのModelクラスからは、後述するPyTensorの自動微分機能を呼び出すことができるので、(2)式のモデルの勾配を求めることができます。
L(x | μ, σ) π(μ, σ)は積の形になっていますが、内部的には対数を取り、log L(x | μ, σ)+ log π(μ, σ)という和の形にして計算が行われます。確率密度の値は小さな値なので、それらの積を求めると誤差が大きくなる可能性があります。そのため、対数を取って和の形にしているというわけです。
実用性はあまりないですが、実験として、上の例で幾つかの値に対する勾配を求めるコードを紹介しておきます。後述するPyTensorの機能を利用しているので、コードの意味については、ここでは詳しくは触れません(PyTensorのお話を読んで、ここに戻ってくると理解できると思います)。リスト1を実行した後で、以下のコードを実行してみてください。
with model:
# 対数確率の勾配(微分係数)を求める計算をコンパイルする
dlogp_fn = model.compile_dlogp(vars=[mu])
# 評価用のパラメーター
point = model.initial_point() # 初期位置
# 勾配を表示する
for point["mu"] in [-1, 0, 1]:
print(dlogp_fn(point))
# 出力例:
# [11.09]
# [0.09]
# [-10.91]
with modelにより、リスト1で作成したmodelを対象とする。compile_dlogpメソッドにより、対数確率の勾配を求めるための計算グラフをコンパイルし、実際に計算ができる関数を作成する。その関数を呼び出せば、それぞれの値に対する勾配が求められる。-1に対する勾配は11.09となっており、右肩上がりであることが分かる。0に対する勾配は0.09なので、上に凸な曲線であれば、ほぼ頂上であることが分かる。1に対する勾配は-10.91なので右肩下がり。なお、勾配の値はsigmaの値にも左右される。このコードにはsigmaが現れないが、initial_pointメソッドにより、リスト1の事前分布の定義(pm.HalfNormal("sigma", sigma=1))を基にした値(1)が自動的に設定されている。
コラム 複雑なモデルを可視化すると
もう少し複雑な例も紹介しておきます(といっても、細かな話になるので、読み飛ばしていただいても構いません)。この連載の第8回で紹介した相関係数の推定のためのコードを基に、モデルを可視化してみましょう。データを作成するためのコードが長くなるのでモデルの定義と可視化の部分だけコードを掲載します(リスト3)。
with pm.Model() as model:
# 平均の事前分布
mu = pm.Normal("mu", mu=0, sigma=1, shape=2) # shape=2により、[mu0, mu1]の形式になる
# 標準偏差の分布
sd_dist = pm.HalfNormal.dist(sigma=1, shape=2)
# 分散・共分散行列(多変量正規分布のパラメーターとして指定)
chol, corr, sigmas = pm.LKJCholeskyCov(
"chol_cov", n=2, eta=2, sd_dist=sd_dist
) # コレスキー分解された分散・共分散行列、相関行列、標準偏差が自動的に作られる
# 相関係数の計算
rho = pm.Deterministic("rho", corr[0, 1])
# 尤度関数(多変量正規分布)
obs = pm.MvNormal("obs", mu=mu, chol=chol, observed=data)
# モデルの構造を見るだけなので、実際のサンプリングは行わない
dot = pm.model_to_graphviz(model) # graphvizのグラフを作成する
dot # グラフを表示する
LKJ事前分布の確率変数の内部的な名前は"chol_cov"であることに注意して、モデルの構造を可視化した結果(後の図3)を見るとよい。この例もモデルを定義しただけなので、サンプリングは行っていない。
実行結果は以下のようになります(図3)。

図3 相関係数の推定を行うためのモデルを可視化した例
LKJ事前分布の定義でコレスキー因子に"chol_cov"という名前を付けたので、標準偏差はその後ろに「stds」を付けた"chol_cov_stds"という名前になり、相関行列は後ろに「corr」を付けた"chol_cov_corr"という名前になる。これらは自動的に作成されるので、コードに記述していないが、グラフ中に可視化される(中央左と中央右の薄い黄色で塗りつぶしたノード)。pymc.Deterministic関数で作成された確率変数(相関係数"rho"など)のノードは四角で囲まれる。
モデル中に定義した、白い背景の楕円が事前分布のノードです。
- 平均の事前分布:「mu~Normal」のノード
- LKJ事前分布:「chol_cov~_LKJCholeskyCov」のノード
図の説明にも記したように、標準偏差と相関行列は自動的に作られます。
- 標準偏差:「chol_cov_stds~Deterministic」のノード
- 相関行列:「chol_cov_corr~Deterministic」のノード
相関行列のPythonでの変数名はcorrなので、その中に含まれる相関係数(corr[0, 1])を取り出しているのが「rho~Deterministic」というノードです。
リスト3では、尤度関数の多変量正規分布に、パラメーターとしてmuとcholが指定されています。「mu~Normal」と「chol_cov~_LKJCholeskyCov」から出ている矢印が、「obs~Multivariate_normal」につながっていることがそれを表しています。
この例ではパラメーターが多いので、やや複雑になりますが、やはり(1)式
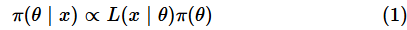
に、
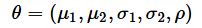
を当てはめた式を基に、密度の高い領域からは多く、密度の低い領域からは少なく取り出されるようにサンプリングが行われます。ただし、実際には、ρそのものをサンプリングするのではなく、サンプリングされた内部のパラメーターを基にコレスキー因子や相関行列を計算し、ρのサンプルの値が求められています。
なお、リスト3のPythonのコードでは添字が0から始まるのでmu[0]、mu[1]となりますが、上記の数式では一般的な表記に合わせてμ1、μ2と1から始めています。
ところで計算グラフって何?
ここまでは、モデルにどのような事前分布や尤度関数が含まれており、どのような構造になっているのかを可視化してきました。また、自動微分の機能についても簡単に紹介しました。モデルの中では、それぞれの確率変数の定義によって計算グラフが作成される、という話を少ししました。その計算グラフとはいったいどのようなものでしょうか。これまで「計算グラフとは計算の方法を定義したもの」のようにざっくりと説明してきましたが、もう少し具体的に見ていきましょう。
確率変数の計算グラフをのぞいてみる
まず、計算グラフに含まれる変数や演算の方法(演算ノード)がどのような構造になっているのかを確認しておきます。確率変数muに対する(muを得るための)計算グラフの構造を表示してみましょう。ここで利用しているのは、リスト3を実行した後のmuです(図1に示した計算グラフの構造はリスト1を実行した後のmuの計算グラフです)。
mu.dprint()
リスト3を実行した後、上のdprintメソッドを呼び出すだけで計算グラフの構造が表示される。実行例は図4に示す。
実行例は以下の通りです(図4)。謎めいた文字や記号が幾つかありますが、大きな構造を見ることにしましょう。リスト3に示した平均の事前分布は2つの独立した正規分布です(ちなみに図1に示した1つの正規分布の場合、実行例はもう少しシンプルです)。

図4 pymc.Normalで定義した事前分布の構造
図4の計算グラフから、平均μ=0、標準偏差σ=1の正規分布を表しており(shape=2なので独立した正規分布が2つ)、乱数生成器を持つ、という構造が分かる。詳細については、以下に箇条書きで示す。
図4の計算グラフについて、詳細を見ていきましょう。箇条書きにします。
1行目: 最初のnormal_rvは正規分布から乱数を生成する演算の定義([id A]は識別のための記号)。(),()->()は入力の次元と出力の次元を表す。この場合は2つのスカラーを入力として、1つのスカラーを出力することになる(ただし、内部的に使われるものなので、確率変数を定義したときのパラメーターの個数や次元とは一致しないこともある)。
2行目: RNGは乱数生成器。
3行目: その次の[2] [id C]はshapeの値。
4~5行目: 続く0 [id E]でmuの値を指定している。ExpandDimsは次元を増やす指定で、ここではスカラーの0をベクトルにしている。shape=2なので、この0は[0,0]と見なされる。
6~7行目: 標準偏差sigmaについても1 [id G]で値を指定している。こちらもやはり[1,1]と見なされる。
ExpandDimsがちょっとややこしいですが、あまり気にする必要はありません。強いて説明するなら、2つの正規分布の平均がいずれも0であるときに、0というスカラーの次元を1つ上げて[0]というベクトルにしているということです。ただし、shape=2なので、同じ値が2つ、つまり[0,0]が指定されたものと見なされます。リスト3で、事前分布を mu = pm.Normal("mu", mu=[0, 0], sigma=[1, 1], shape=2) のように指定すると、dprintメソッドの出力にはExpandDimsが表示されず、[0 0] [id D]、[1 1] [id E]のように、配列がそのまま表示されます。
しかし、この例では、具体的にどのようにして計算ルールを決めているのかは謎ですね。実際のところ、それぞれの計算ルールを知らなくても使える、というのがPyMCの利点なのですが、やはり計算ルールをどのようにして定義するか知りたいですよね。
PyTensorで計算グラフを作ってみる
実は、pymcで定義された確率変数はPyTensorの計算グラフに含まれるTensorVariableとして表されています。PyTensorは多次元の配列を含む式やその計算方法を計算グラフとして定義したり、評価(計算)したりするためのライブラリです。そして、TensorVariableは、多次元の配列を表すシンボル(値そのものではなく、変数を表す記号のようなもの)です。
そこで、PyTensorを使って簡単な計算グラフを作成し、実際に計算してみることにしましょう。そうすれば、その延長線上に図4に示した構造がある、ということが(おぼろげながら)理解できると思います。リスト5でその例を見てみます。足し算のルールを作るというごく簡単なものです。
import pytensor
import pytensor.tensor as pt
# 変数や計算のルールを決める
x = pt.scalar("x") # TensorVariable
y = pt.scalar("y") # TensorVariable
z = x + y # 演算ノード(zはその結果を表すTensorVariable)
# 計算グラフを実際に計算できる関数にコンパイルする
f = pytensor.function([x, y], z) # xとyを与えてzの結果を求める関数
# 関数を呼び出す
f(3, 4)
# 出力例:
# array(7.)
pytensor.tensorモジュールを利用すれば、多次元の配列を表すシンボルが定義できる。例えば、pytensor.tensor.scalarはスカラーを、pytensor.tensor.vectorはベクトルを、pytensor.tensor.matrixは2次元の配列を、pytensor.tensor.tensor3は3次元の配列を定義するのに使われる。演算ノードの定義は一般的な四則演算やNumPyの関数とほぼ同じ(上の例では単なる足し算)。pytensor.function関数により、計算グラフを実際に計算できる関数にコンパイル(翻訳)する。
計算グラフとは、変数(TensorVariable)や演算ノードを含む、計算のルール(計算の構造)と考えられます。あくまで「ルール」なので、実際に計算するには、計算を行うための関数にコンパイル(変換)する必要があります。リスト5のpytensor.functionという関数がコンパイルを行ってくれます。作成された関数を呼び出せば、実際の計算ができるというわけです。
ちなみに、dprintメソッドを使って表示した計算グラフの構造は以下のようなものになります(リスト6)。
z.dprint()
# 出力例:
# Add [id A] 0
# ├─ x [id B]
# └─ y [id C]
# <ipykernel.iostream.OutStream at 0x7a72dffb3490>
dprintメソッドで構造を表示した。zが、xとyを加える(Addする)計算であることが分かる。なお、最後の行は計算グラフの構造ではなく、dprintメソッドの戻り値(出力先のオブジェクト)がGoogle Colabによって表示されたものなので無視してよい。
さらに、図4とのつながりを多少イメージできるように、乱数生成器を作ってみましょう。正規乱数を作成するコードはnumpyのrandom.normal関数と同じ書き方です。
import pytensor
import pytensor.tensor as pt
# 変数や計算のルールを決める
size = pt.scalar("size", dtype='uint16') # 乱数の個数
x = pt.random.normal(loc=0, scale=1, size=size) # 正規乱数をsize個作る
# コンパイルする
f = pytensor.function([size], x)
# コンパイルされた関数を呼び出す
f(5)
# 出力例:(実行のたびに結果は異なります)
# array([ 0.35097104, 0.92086426, 0.31778036, -0.28316244, 0.37991476])
乱数生成器といっても、次々と新しい乱数を作るものではなく、単に幾つかの乱数を作るものとした。演算ノードでの計算にはNumPyの関数とほぼ同じものが使える。
この例は、単に幾つかの乱数を作るだけのものですが、pymc.Normalクラスは正規分布を確率モデルの中で取り扱うためのさまざまな機能を提供しています。具体的には、乱数の生成だけでなく、確率密度の計算や自動微分による勾配の計算などの機能も数多く含まれています。
確率密度と勾配を計算してみる
そこで、pymc.Normalクラスに含まれる確率密度の計算と自動微分の機能を少しばかり体験してみましょう。標準正規分布であれば結果が分かりやすいので、x=-1, 0, 1に対する対数確率密度と勾配を表示してみます(リスト8)。ただし、若干複雑になるので、自動微分がどのようなものであるかを初歩の初歩から知りたい方は、サンプルファイルに含まれているごく簡単な例(y=x2を微分する例)を参照してください。
import pytensor
import pytensor.tensor as pt
import pymc as pm
value = pt.scalar("mu")
logp = pm.logp(pm.Normal.dist(mu=0, sigma=1), value) # 確率密度の対数を求める
# 自動微分する
dlogp = pt.grad(logp, value)
# コンパイルする
f = pytensor.function([value], [logp, dlogp])
# 勾配を表示する(対数確率密度と勾配が表示される。標準正規分布の場合、勾配は-xの値と等しい)
for x in [-1, 0, 1]:
print(f(x))
# 出力例:
# [array(-1.41893853), array(1.)]
# [array(-0.91893853), array(-0.)]
# [array(-1.41893853), array(-1.)]
pymc.Normalクラスに含まれるdistメソッドを利用すると、正規分布から確率変数の値を求めるためのTensorVariableが作成される。pymc.logp関数は、指定された確率変数に対する対数確率密度を求める関数。pytensor.tensor.grad関数により、logpをvalueで微分する(ここまでは、あくまで値を求めるのではなく、計算ルールを定義している、ということ。念のため)。pytensor.functionで、valueを入力とし、logpとdlogpという計算を行う関数fにコンパイルする。最後に関数fに[-1, 0, 1]を与えて対数確率密度と勾配を表示する。
標準正規分布では、x=-1に対する確率密度は0.241970725です。その自然対数を取るとln 0.241970725=-1.41893853となり、結果として表示された1行1列目の値と一致します。また、xに対する勾配は-xです。これも1行2列目の1という値と一致しています。
先ほど、PyTensorの延長線上にPyMCがあると言いましたが、リスト8などを見ると、むしろ、PyMCが内部的にPyTensorを呼び出すことによって、複雑な計算を自分で定義しなくても簡単に事前分布や尤度関数が定義できるようにしている、といった方が適切ですね。
少しばかりちゃぶ台返しのような話です。pymc.Normalクラスには乱数生成器が含まれますが、実際のMCMCサンプリングでは、その乱数生成器が使われるわけではありません(事前予測分布の作成などには使われます)。
ここでは、PyTensorの機能のうちのごく一部しか紹介していないので、これだけでは、PyTensorのメリットがあまり感じられないかもしれません。しかし、PyTensorには多次元配列に対するさまざまな演算や上で少し触れた自動微分などの機能が含まれているので、ベイズ統計や機械学習だけでなく、科学技術計算などで幅広く使えます。
コラム 計算グラフをもう少しビジュアルにするには
pytensor.printingモジュールのpydotprint関数を利用すれば、ノードとエッジのグラフをよりビジュアルに表示できます。以下のように、出力ファイルを指定して実行し、そのファイルを開けば、画像が表示されます(リスト3でのmuについての計算グラフです)。
from pytensor.printing import pydotprint
# muの計算グラフを可視化する。出力ファイルはmu.pngとする
pydotprint(mu, outfile="mu.png")
リスト3のコードを実行して定義された平均の事前分布muの計算グラフを表示する。ただし、そのままグラフが表示されるのではなく、画像ファイルが作成される。Google Colaboratoryの場合、作成されたmu.pngファイルが左側のファイル一覧に表示される。ダブルクリックすると、図5のような画像が表示される。
リスト9で作成された計算グラフは図5のようになります。

図5 pymc.Normalで定義した事前分布の構造をビジュアルに表示する
val=0のノード(左上)が平均、val=1のノード(右上)が標準偏差。val=[2]のノードはshapeを表す。明るいブルーのRandomGeneratorTypeというノードは乱数生成器の現在の状態。ExpandDimsは次元を拡張するという演算(この例では、スカラーからベクトルになる)。これらがnormal_rvに入力される。出力されるのはグレーのRandomGeneratorType(こちらは乱数生成器の次の状態)と、濃いブルーの確率変数"mu"(shape=(2,)となっていることから要素数2のベクトルであることが分かる)。
今回は、モデルの構造や計算グラフの可視化を通して、PyMCを身近に感じられるようにしようという趣旨で、幾つかの例を見ました。また、PyTensorのTensorVariable、演算ノード、関数へのコンパイルなどの簡単な例を紹介し、自動微分などの機能についても触れました。さすがに、その先のNUTSなどの具体的なアルゴリズムまで踏み込むと、底なし沼にはまってしまいますが、内部の仕組みにも多少は触れておいた方が実感を持ってPyMCを利用できるのではないかと思います。もちろん、本来は内部のアルゴリズムをすべて理解して、自分でコードを書かなくても、モデリングやサンプリングができる、というのがPyMCのメリットなのですが。
さて、次回は本編に戻って、ベイズ回帰分析に取り組みたいと思います。まずは、「回帰式の当てはまりの良さ」を分析してみます。次回もどうぞお楽しみに!
今回使った新出のクラス・関数・メソッド(主なもの)
引数も主なものだけを掲載します。引数に「=値」と書かれたもの(例:vars=None)は既定値を表します。
model_to_graphviz: モデルをGraphvizのグラフに変換する関数
- モジュール: pymc
- 形式: model_to_graphviz(model)
- 引数:
- model: Graphvizのグラフに変換したいモデル
※pymc.model_graphモジュールに含まれますが、pymc.model_to_graphvizで呼び出せます。
compile_dlogp: 対数確率の勾配を求める計算グラフをコンパイルするメソッド
- モジュール: pymc.Model
- 形式: compile_dlogp(vars=None)
- 引数:
- vars: どの確率変数に対する勾配を求めるかを指定する。省略すると利用できるすべての確率変数を対象とする
dprint: 計算グラフの構造を表示するTensorVariableオブジェクトのメソッド
- 形式: dprint()
※pytensorモジュールのdprint関数を使っても同じことができます。例:mu.dprint()の代わりにpytensor.dprint(mu)としても同じ結果が表示される。
scalar: スカラー型のTensorVariableオブジェクトを作成する
- モジュール: pytensor.tensor
- 形式: scalar(name=None, dtype=config.floatX)
- 引数:
- name: 内部で使われる変数の識別名
- dtype: データのタイプ。既定値のconfig.floatXは、現在の環境で使われる浮動小数点型
normal: 正規乱数を生成するための計算グラフを作成するオブジェクト
- モジュール: pytensor.tensor.random
- 形式: normal(loc=0.0, scale=1.0, size=None)
- 引数:
- loc: 平均
- scale: 標準偏差
- size: 生成するTensorVariableの形。Noneの場合はlocとscaleの形を基に決められる
grad: 入力値に対する勾配を求めるための計算グラフを作成する関数
- モジュール:pytensor.tensor
- 形式:grad(cost, wrt)
- 引数:
- cost: 勾配を求める(微分したい)関数の計算グラフ
- wrt: 微分を行うための入力とする変数(Xに当たるもの)
※pytensor.gradientモジュールに含まれますが、pytensor.tensor.gradで呼び出せます。
logp:確率密度の対数を求める計算グラフを作成する関数
- モジュール: pymc
- 形式: logp(rv, value)
- 引数:
- rv: 確率変数(確率分布)
- value: 確率変数の値
function: 計算グラフをコンパイルするための関数
- モジュール: pytensor
- 形式: function(inputs, outputs)
- 引数:
- inputs: 入力されるTensorVariable
- outputs: 計算結果を表すTensorVariable(計算グラフの出力)
※返り値として、コンパイルされた(実際に計算ができる)関数が返される。
pydotprint: 計算グラフを可視化した図を作成する関数
- モジュール: pytensor.printing
- 形式: pydotprint(fct, outfile=None)
- 引数:
- fct: コンパイルされた関数またはTensorVariable
- outfile: 出力ファイル。省略時は自動的に名前が付けられ、既定のフォルダーに保存される
Copyright© Digital Advantage Corp. All Rights Reserved.