【Pythonで学ぶデータ分析】独立性の検定をベイズ統計で行う ~ 雨男・雨女は本当にいるのか?:やさしい推測統計(ベイズ統計編)
その人が行事に参加すると高い確率で雨が降る、そんな「雨男・雨女」が身近にいるという人は少なくないと思います。冷静に考えれば、そういう印象が強いだけかもしれません。そこで、本当に雨男・雨女がいるのかをベイズ検定してみましょう。いわゆる独立性の検定に当たります。『社会人1年生から学ぶやさしいデータ分析』ベイズ統計編の第9回です。
この記事は会員限定です。会員登録(無料)すると全てご覧いただけます。
独立性の検定をベイズ統計で行うには? 連載『社会人1年生から学ぶ、やさしいデータ分析』のベイズ統計編、第9回となる今回は、古典的な独立性の検定(いわゆるカイ二乗検定)に代わるベイズ検定の方法を解説します。事前分布には、ベータ分布を多変量に拡張したディリクレ分布を使い、尤度(ゆうど)関数として二項分布のカテゴリを3つ以上に拡張した多項分布を使います。分析の進め方はこれまでとほとんど同じですが、今回はオッズ比の推定を行います。それぞれの分布やオッズ比の意味を確認しながら、ゆっくりと見ていきましょう。
この連載では、簡単な事例を通してベイズ統計の考え方と分析の進め方を解説します。新しい用語や考え方が幾つも出てきますが、全てを理解しなくても大丈夫です。登場するたびに、分かりやすく丁寧に説明するので、その時点で分からないことがあっても気にせず、先に進んでください。回を追うごとに、少しずつ理解が深まります。どんな考え方で、どんな手順で分析を進めるのか、といった大きな流れを捉えてください。
連載:

この連載では、データをさまざまな角度から分析し、その背後にある有益な情報を取り出す方法を学ぶ『社会人1年生から学ぶ、やさしいデータ分析』シリーズの「記述統計と回帰分析編」「確率分布編」「推測統計(区間推定編・仮説検定編)」に続く「ベイズ統計編」です。
これまでの推測統計を土台に、近年活用が広がっているベイズ統計の考え方と分析手順を、古典的な手法との違いを整理しながら解説します。初めての方でも無理なく理解できるよう具体例を通して進めるとともに、ベイズ的なアプローチの特徴やメリットを実感できる構成とし、「どのように考え、どう使い分けるのか」に重点を置いて解説していきます。
 羽山博
筆者紹介: IT系ライターの傍ら、かつて、非常勤講師として東大で情報・プログラミング関連の授業を、一橋大でAI関連の授業を担当。まだ発展途上のようだが、生成AIへの質問と回答を分野ごとにまとめ、体系的に整理、補足しつつ、さらに個別の学びを促す記述を加えた資料を一貫して作成できるツールが実用レベルで本格的に使えるようになると、書籍の概念が変わるのではないかと思ったりしている。一斉授業だったものが、ユーザーに合った個別指導のできる書籍といったイメージ。そうなると、出版社のビジネスモデルも大きく変わり、私の仕事もなくなってしまいそうだけど、まあ、そのときは、縁側でお茶でもすすりながら、庭の景色を眺めて暮らすことにしようと思う。ウチには縁側も庭もないけど。
カテゴリ間に関係があるかどうかをベイズ検定によって分析する
前回は、ベイズ相関検定により変数同士に関係があるかどうかを調べました。今回も関係に注目して分析を進めていきたいと思います。前回のデータは「年齢」と「原付事故の死傷者数」という間隔尺度のデータでしたが、今回のデータは、カテゴリを区別するのに使われる名義尺度のデータです。例えば「雨男・雨女」という変数の値は数値ではなく、YESかNOかで区別されます。また、天気についても「雨」か「晴」かで区別されます(曇りや雪などもありますが、話を簡単にするために2つに分けることにします。なお、本稿では表記を統一するため「晴れ」を「晴」と記します)。
その場合の「生の」データは、表1のようなものになります。
| サンプル | 雨男・雨女 | 天気 |
|---|---|---|
| 1 | YES | 雨 |
| 2 | YES | 雨 |
| 3 | NO | 晴 |
| : | : | : |
この表を見れば、それぞれの変数の値が数値ではなくカテゴリを区別する文字であることが分かる。このようなデータが名義尺度のデータ。分析には、これらを集計した値を使う。
表1のようなデータは、それぞれの個数(度数)を集計したクロス集計表の形で表されます(図1)。もし、雨男・雨女と呼ばれる人がいたときに、本当に雨がよく降るなら、左上の「雨」の比率が高くなるはずです。この場合は、雨男・雨女であるかどうかと、天気に関係があるので「独立ではない」ということになります。一方、雨男・雨女が「気のせい」であるなら、雨男・雨女の「雨」と「晴」の比率は、普通の人の「雨」と「晴」の比率と変わらないことになります。その場合は、雨男・雨女であるかどうかと、天気には関係がないので「独立である」ということになります。今回のテーマは、そのような「独立であるかどうか」を調べることです。なお、データは架空のものです。
 図1 2つの変数が独立であるかどうかをベイズ検定により確かめる
表1の生データの度数を数えてクロス集計表にしたもの。75人の人を集めて「雨男・雨女」と呼ばれるかを聞き、ランダムに指定した外出日に実際に雨が降ったかどうかを調べた結果。といっても、話を分かりやすくするために「雨男・雨女は確かにいる」という方向で恣意的に作った架空のデータとなっている。このクロス集計表の値を基にベイズ推定/検定を行う。図の下に記された分析の方法や結果については、この後で見ていく。ちなみに、古典的な独立性の検定で使われるカイ二乗分布は使わない。
図1には、新たに登場した用語が幾つかありますね。事前分布として利用するディリクレ分布、尤度関数の多項分布、ベイズ推定/検定で利用するオッズ比の3つです。図2で分析の全体像をざっと確認した後、これらの意味についてひととおり見ていきましょう。その後で分析に取り組みます。
 図2 事前分布と尤度関数、推測したい値(オッズ比)
今回のデータは2×2の分割表(セルは4つ)となっている。そこで、各セルの確率の事前分布を表すためにディリクレ分布を利用する。ディリクレ分布はベータ分布を多変量に拡張したもの。尤度関数は多項分布とする。多項分布は、二項分布を結果が3つ以上の場合に拡張したもの。推測したいパラメーターは、各セルの確率を基に計算して求めた「オッズ比」とする。
図2では、知りたいのはオッズ比で、事前分布としてディリクレ分布を、尤度関数として多項分布を使う、ということだけ確認していただければ十分です。これから、オッズ比の意味やこれらの分布がどのようなものであるかを見ていきます。

実は、分割表のモデルにはさまざまなものがあり、この例のように総数が固定されている(最初から75人集めるものとした)場合はジョイント多項分布モデルとなります。他にも、総数を固定しない(調査してみたら75人集まった)場合のポアソン分布モデルなどがあります(宮川・青木, 2018)。古典的なカイ二乗検定では、モデルが異なっても同じ方法で検定ができますが、ベイズ検定では、モデルを使い分ける必要があります。今回はジョイント多項分布モデルを取り扱いますが、サンプルプログラムとしてはポアソン分布モデルによるものも含めてあります(後述します)。
オッズ比により起こりやすさに違いがあるかを比べる
図1や図2で、まず押さえておきたいのがオッズとオッズ比です。オッズは、どちらがどの程度起こりやすいか(有利か)を表す値で、確率の比で表されます。従って、各セルの確率を求めてその比を計算すればいいのですが、図1の値をそのまま使っても同じ結果となります。例えば、雨男・雨女の場合、雨と晴のオッズは、20/10=2.0です。雨の方が起こりやすいというわけです。一方、普通の人の場合、雨と晴のオッズは15/30=0.5です。こちらは晴れの方が起こりやすいですね。
オッズ比(OR:Odds Ratio)は、オッズの比です。確率の比であるオッズをそれぞれ求めて、さらにそれらの比を求めるというわけです。上の例の場合は「雨男・雨女のオッズ/普通の人のオッズ」で求められるので、2.0/0.5=4.0となります。図1の各セルの値を使って表すなら、以下のようになります。
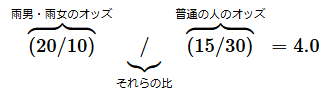
表の左上や右下の割合が大きい場合、このように、オッズ比が1より大きくなります。
比率に違いがない場合はオッズ比が1になります。仮に、雨男・雨女の「雨」が10で、「晴」が20だったとしましょう。その場合、オッズ比は(10/20) / (15/30) = 0.5/0.5 = 1.0となります。雨男・雨女であっても、普通の人であっても、雨と晴の比は同じですね(この場合は人によって天気に違いはないので独立です)。
表の右上や左下の割合が大きい場合はオッズ比が1より小さくなります。例えば、雨男・雨女の「雨」が10、「晴」が20で、普通の人の「雨」が30、「晴」が15の場合がそれに当たります。むしろ普通の人の方が雨をよく降らせる、という考えにくいパターンですが、この場合のオッズ比は(10/20) / (30/15) = 0.5 / 2 = 0.25となります。
少しだけ一般化しておきます。各セルの確率を、左上、右上、左下、右下の順にp1, p2, p3, p4とすると、オッズ比は、

と表されます。ただし、この式は割り算が連続して見づらいので、以下のように変形した式を使うことにしましょう(結果は同じです)。

というわけで、オッズ比を推定し、ベイズ因子を求めれば、今回の分析ができます。古典的な独立性の検定では「独立」か「独立でない」かを調べましたが、オッズ比を利用すれば、独立でない場合に、どの方向に効果があるかが分かります。
では、オッズ比をどのようにしてベイズ推定するのでしょうか。そのためには、尤度関数として利用する多項分布と事前分布として利用するディリクレ分布がどのようなものであるかを知っておく必要があります。
多項分布とディリクレ分布
この連載の第2回では「タッチングというケアの手法は癒やしに役立つのか」という事例を紹介しました。その際に利用した二項分布について少しおさらいしておきましょう。役に立つ確率(成功確率)をpとしたとき、n人中x人が「役に立つ」度数は二項分布に従います。例えば、p=0.7のとき、10人中6人が役に立つ確率(確率質量関数の値)は以下のようになります。とりあえず、式の意味や結果の値はあまり気にしなくても構いません。
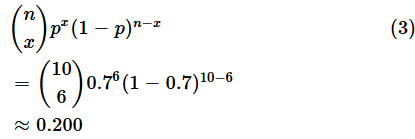
二項分布の各試行の結果は「成功」と「失敗」の2つに分かれます。従って、成功確率がpであれば、失敗確率は1-pです。試行は成功するか失敗するかしかないので、成功確率と失敗確率を足すと1になることに注意してください(全体の確率が1になるのは当然のことですね)。
ここまでは、二項分布とはどのようなものかという理論分布のお話です。しかし、実際には真のpの値は分からないので、第2回の分析では、観測されたデータを基に、二項分布の母数であるpの値をベイズ推定しました。その際、pは0~1の範囲の値を取るので、pの事前分布として台が0~1であるベータ分布を使ったというわけです(ただし、第2回で紹介した式では、pの代わりにθ、xの代わりにkという文字を使いました)。
今回の例を見てみましょう。結果は4つに分かれていますね。つまり「雨男・雨女で雨」「雨男・雨女で晴」「普通の人で雨」「普通の人で晴」の4つです。このように結果が3つ以上に分かれる場合は多項分布が使えます。それらの人数を順にx1, x2, x3, x4とします。
ここで、1回の試行でそれぞれの結果が得られる確率を順にp1=0.3,p2=0.1,p3=0.2,p4=0.4としてみましょう。p1~p4の合計が1になることに注意してください。
この場合、例えば、n=75人中(つまり75回の試行で)、x1=20人、x2=10人、x3=15人、x4=30人となる確率は、以下のような多項分布の確率質量関数の値となります。
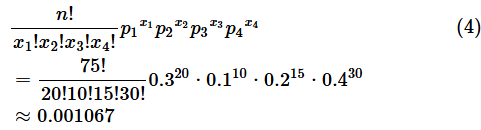
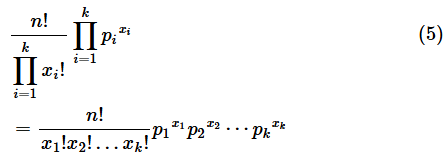
ここまでは、多項分布とはどのようなものかという理論分布のお話でした。やはり、多項分布のパラメーターp1, p2, p3, p4の真の値は実際には分からないので、観測されたデータを基に、パラメーターp1, p2, p3, p4をベイズ推定しようという話になります。その場合、二項分布の母数pを推定するためにベータ分布を事前分布として利用したのと同様、多項分布の母数p1, p2, p3, p4を推定するために、多変量のベータ分布に相当するディリクレ分布を事前分布として使います。つまり、表2のような使い方になります。
| 成分数k | 尤度関数 | 確率変数 | パラメーター | (共役)事前分布 | 確率変数 | パラメーター |
|---|---|---|---|---|---|---|
| 2 | 二項分布 | x | p | ベータ分布 | p | α, β |
| 2以上 | 多項分布 | xi | pi | ディリクレ分布 | pi | αi |
ただし、i = 1, …, k、0 ≤ p, pi ≤ 1、Σki=1 pi=1
成分数とは、結果が何通りに分けられるかということ。2成分のディリクレ分布はベータ分布と等価。この連載ではPyMCを使って推定などを行うが、表に示した事前分布は共役事前分布なので解析解を求めることもできる。確率変数については、具体的に得られた値を意味する小文字で書いている。
二項分布のパラメーターは成功確率pです。それを推定するためにpを確率変数とした、パラメーターα,βのベータ分布を利用する、ということでしたね。ベータ分布の累積分布関数を使えば、pが0.5より小さい確率なども推定できるということでした。
今回の例では、結果が4つの場合に分かれるので、尤度関数として4成分の多項分布を使います。表2では、k=4に当たる場合です。2×2分割表の各セルの確率はp1, p2, p3, p4となります。それらを推定するために、p1, p2, p3, p4を確率変数とした、パラメーターα1,α2,α3,α4のディリクレ分布を利用します。
ここで、p1, p2, p3, p4は各セルの確率を表すので、いずれも0~1の範囲の値を取ることを思い出してください。また、p1, p2, p3, p4の合計は1になります。
p1, p2, p3, p4が推定できれば、オッズ比も(2)式で推定できます(再掲します)。

二項分布のパラメーターは成功確率pですが、成功確率をp1、失敗確率をp2と表すこともできます。その場合、p1 + p2 = 1という制約があります。表2を見れば、k=2の多項分布と同じであることが分かります。その場合は、ベータ分布と等価な2成分のディリクレ分布(α1=α, α2=β)を事前分布として使うこともできます。むしろ、二項分布やベータ分布は、多項分布やディリクレ分布の(k=2の場合の)特殊な例と考えられます。
多項分布は二項分布からの類推である程度イメージが湧くと思いますが、ディリクレ分布がベータ分布の多変量版だと言われても、あまりイメージが湧かないかもしれません。そこで、ディリクレ分布を可視化した例を下のコラムに掲載しておきました。コラムの内容を読まなくても、これまでの流れで独立性のベイズ推定/検定はできるので、お急ぎの方は「事前分布と尤度関数を定義して、サンプリングを行う」という項まで進んでいただいても構いませんが、コラムに目を通していただくと、ディリクレ分布を使う理由が実感できると思います。
コラム ディリクレ分布を可視化する
表2のキャプションに示したように2成分のディリクレ分布はベータ分布と等価です。まず、それを可視化した例を以下の図3に示します。ベータ分布と同じなので、疑問に思う点はないかと思います。
なお、このコラムで取り上げるグラフはサンプルファイルのコードを実行すれば表示できます。ただし、少し長くなるのでそれらのコードセルは非表示にしてあります。実際に試してみたい方は、リンクを開き、最初の「ディリクレ分布を可視化する」というテキストセルの左上にある[>]ボタンをクリックし、コードセルを表示してください。準備として、最初のコードセルをクリックし、[Shift]+[Enter]キーを押して実行すれば、必要なライブラリがインストールされます。続いて、2番目以降のコードセルを実行すれば、グラフが表示されます。ただし、コードの詳細については、本筋の話から外れてしまうので、特に解説はしません。
 図3 2成分のディリクレ分布(ベータ分布と等価)
パラメーターを(4, 4)としたディリクレ分布の例。ちょっと見づらいが、x軸の少し上に表示された点がディリクレ分布からランダムにサンプリングした点(そのままだと数が多くて点に見えないので、間引いて表示してある)。確率密度が高い位置の点は濃い色で表示されるようにした。サンプリングされた点の度数をヒストグラムにしたものと、ディリクレ分布の確率密度関数のグラフも併せて表示した。
2成分のディリクレ分布の場合、パラメーターはベータ分布と同じ(α, β)です。2成分のディリクレ分布からランダムにサンプリングすると、(p1, p2)という2つの値が返されます。上のグラフに表示されている「サンプリングした点」は、p1の位置に点を打ったものです(x軸と重なると見づらいので、少し上に表示してあります)。その場合、2成分をp1, p2とすると、p1+p2=1という制約があることに注意が必要です。なお、ベータ分布の確率変数pがp1に当たります(p2は1-p1で自動的に求められます)。
サンプリングされた点が多く集まっている(密度の高い)場合は、点の色を濃くしてあります。それらの点の数を階級ごとに数えてヒストグラムにしたものが薄いブルーのグラフ(全体を1としたもの)です。ヒストグラムが確率密度関数のグラフとほぼ重なることが分かります。余談ですが、サンプリングされた点の集まり具合と見比べると、確率「密度」関数と呼ばれる意味がよく分かりますね。
次に3成分のディリクレ分布を見てみましょう。パラメーターはα=(α1, α2, α3)のように3つになります。各パラメーターを(α, β, γ)のように別の文字で表すこともできますが、文字が多くなり、取り扱いが面倒なのでαの添え字で区別します。
それぞれの成分を(p1, p2, p3)とすると、p1 + p2 + p3 = 1という制約があることに注意が必要です。例えば、p1=0.5, p2=0.3とすると、p3=1-(p1+p2)=1-(0.5+0.3)=0.2となります。これを可視化すると、図4のような正三角形の内側に位置することになります。
念のため確認しておきます。α=(α1, α2, α3)はディリクレ分布の形状を決めるパラメーターで、(p1, p2, p3)はディリクレ分布から取り出された3つの値、あるいは観測値です。
 図4 3成分のディリクレ分布
パラメーターをα=(4, 4, 4)とした3成分のディリクレ分布から、ランダムにサンプリングした点を表示した例。サンプリングされた点(p1, p2, p3)は2次元の平面上に位置する。ただし、p1 + p2 + p3 = 1という制約があるので、図に示した正三角形を座標軸とする平面上の点と考えられる。成分が増えると、確率密度関数を可視化するのが難しくなるので、色の濃い部分が高い山になっているというイメージで見るとよい。観測値(p1, p2, p3)=(0.5, 0.3, 0.2)の位置を×印で示してある。
続けて、4成分の例も見てみましょう。パラメーターはα=(α1, α2, α3, α4)のように4つになります。サンプリングされた点は、p1 + p2 + p3 + p4 = 1という制約があるので、図5に示した正四面体を座標軸とする空間内の点となります。サンプルファイルのコードを実行すると、マウスでドラッグして回転させたり、ホイールの操作で拡大/縮小できるグラフが表示されます。
 図5 4成分のディリクレ分布
サンプルプログラムを実行すると、マウスの操作でグリグリと回転・拡大/縮小ができる図が表示される。この例は、パラメーターをα=(4, 4, 4, 4)とした4成分のディリクレ分布から、ランダムにサンプリングした点を表示したもの。p1 + p2 + p3 + p4 = 1という制約があるので、図に示した正四面体を座標軸とする空間内の点と考えられる。点の密度が高い部分を濃い色で表してある。また、観測値(20, 10, 15, 30)を確率に変換した値(p1, p2, p3, p4)=(0.267, 0.133, 0.200, 0.400)の位置を×印で示してある。
図5を表示するためのコードで、パラメーターをいろいろと変えて試してみると楽しいと思います。例えば、図5のコードでalpha = [1, 1, 1, 1]とすると空間内に一様にサンプルが分布し、alpha = [10, 10, 10, 10]とすると、中心付近の密度が高くなります。また、alpha = [4, 1, 1, 1]とすると、x1の近くの密度が高くなり、alpha = [1, 4, 4, 1]とすると、x2とx3を結ぶ線の近くの密度が高くなります。
事前分布と尤度関数を定義して、サンプリングを行う
それでは、いよいよ分析に取りかかります。今回のデータは2×2の表(配列)として集計されているので、簡単に表せます。以下の通りです。データの合計も求めておきます。
data = np.array([[20, 10],
[15, 30]])
total = data.sum() # データの合計
事前分布や尤度関数の定義はこれまでに見てきた知識でできます。一気に見ていきましょう。必要な情報を箇条書きにしておきます。
- 事前分布: 4成分のディリクレ分布。パラメーターはα=(1,1,1,1)とする(一様分布を想定)
- 尤度関数: 多項分布。観測データは上で作成したdataを1行に並べたものとする。2×2の表であれば、左上→右上→左下→右下の順。つまり[20, 10, 15, 30]
- オッズ比: pymc.Deterministic関数を使い(2)式に従って定義する
コードは以下の通りです。サンプルファイルの「オッズ比のベイズ推定」というテキストセルの下のコードセルに、データの作成と併せて以下のコードが入力されています。コードセルをクリックし、[Shift]+[Enter]キーを押して実行すれば、サンプリングが行われ、結果の要約が表示されます。コードの説明はリスト1の後にまとめます。
with pm.Model() as model:
# 事前分布:ディリクレ分布(無情報)
probs = pm.Dirichlet("probs", a=np.ones(4), shape=4)
# 尤度関数:多項分布
obs = pm.Multinomial("obs", n=total, p=probs, observed=data.flatten())
# オッズ比:(p1/p2) / (p3/p4) = (p1*p4) / (p2*p3)
ratio = pm.Deterministic("ratio", (probs[0] * probs[3]) / (probs[1] * probs[2]))
# サンプリング
trace = pm.sample(8000, chains=2, random_seed=42)
# 結果の要約
az.summary(trace, var_names=["probs", "ratio"])
箇条書きにした情報に基づいて素直にコードを書いた例。pymc.Dirichletクラスにより、ディリクレ分布を定義する。尤度関数はpymc.Multinomialクラスで定義。オッズ比は(p1 × p4) / (p2 × p3)で求める。probsのインデックスが0から始まっているので、p1がprobs[0]に対応することに注意(それ以外も同様)。
pymc.Dirichletクラスの引数aにはパラメーターα=(α1,α2,α3,α4)の値を指定します。ここでは、どのセルも同程度の確率で、分布が集中していない(事前の情報がない)ことを想定してnp.ones(4)を指定しています。これは、1が4つ並んだ配列なので、np.array([1, 1, 1, 1])と同じです。なお、雨の日よりも晴(雨以外)の日の方が多いので、それを反映するなら、np.array([1, 4, 1, 4])といった指定にするのも合理的です。が、ここではリスト1の通りに進めてみます。shape引数には何成分のディリクレ分布であるかを指定します。
pymc.Multinomialクラスの引数については、特に難しいところはありませんね。nにはデータの総数を、pには各セルの確率を表す確率変数(pymc.Dirichletの返り値)を、observedには観測されたデータを指定します。observedには、各セルの実測値そのものを指定することに注意してください。
pymc.Deterministic関数についても詳しく説明する必要はないですね。(2)式に従ってオッズ比を計算しています。
サンプリングの結果は以下の通りです。
 図6 事後分布の要約
meanの列に各セルの確率(probs[0]~probs[3])とオッズ比(ratio)の点推定値が表示されている。オッズ比の94%信用区間が1.116~8.570となっており、区間全体が1よりも大きい。つまり、左上(雨男・雨女で雨)と右下(普通の人で晴)の割合が、独立の場合よりも大きいということになる。この結果から、雨男・雨女は存在する、と言ってよさそうである。
図6を見ると、雨男・雨女であるか、普通の人であるかによって、天気は異なる(=雨男・雨女は存在する)と言えそうです。もちろん、現実がそうだというわけではなく、わざとその方向の架空データを用意したので、当然の結果です。
余談です。プロ野球好きの方にはよく知られた話ですが、ある投手が登板する日には雨が降る、と言われている人がいます(名前は掲載しませんが、気になる方は「投手 雨男」で検索してみてください)。実際のその人のデータを調べてみると確かに雨が多いようでした。やはり雨男は存在する、と言いたくなりますね。しかし、特定の個人が雨を呼ぶというのは科学的にはまずあり得ないことです。登板間隔と天気の変わるサイクルがたまたま一致した可能性が高いものと思われます。
最初に少し触れたように、この例はジョイント多項分布モデルによるものです。サンプルファイルには、参考として各セルの期待度数をポアソン分布でモデル化した例も含めてあります。
なお、オッズ比はベースラインと呼ばれる値(今回の例であれば「普通の人で雨」である割合)が高いと、実態よりも大きな効果があるものと勘違いしてしまうことがあります。例えば、図6のprobs[0]~probs[3]を基に、普通の人で雨である確率を求めると、0.202/(0.202+0.392)=0.340です。雨男・雨女がその4.379倍だとすると0.340×4.379=1.489という確率としてはあり得ない値になります。もちろん、それは誤りですが、そのような印象を与えてしまうというわけです。実際には、雨男・雨女で雨である確率は0.267/(0.267+0.139)=0.658です。そのため、オッズ比と併せて、確率の比や差を報告することもよくあります。この場合だと、確率の比は0.658/0.340=1.94つまり約2倍です。差は0.658-0.340=0.318(31.8%)となり、この例では実態としてもかなり大きな比(差)となっています。
推定されたオッズ比をどう評価するか(オッズ比の値がどの程度であれば関連が強いと言えるのか)については、Chen, H., Cohen, P., & Chen, S. (2010)でのオッズ比とCohen's dとの変換式などを参照していただくといいかと思います。論文の要約と変換のための式だけであればこちらで見ることもできます。計算式を見ると、ベースライン(論文中のP0の値)によって結果が異なることも分かります。サンプルファイルには、オッズ比をCohen's dに変換した例(点推定値は0.836)や、確率の差をCohen's hに変換した例(点推定値は0.655)を参考として含めてあります。
続けて、ベイズ因子も求めます……が、その前に、効果量のお話が少し登場したので、一点だけ留意点を。というのも、これまでは、コードの書き方を中心にお話を進めてきたので、ベイズ推定を行ってからベイズ因子を求めるという順序で説明してきました(その方がステップバイステップで理解できるので)。しかし、分析の結果を報告する場合には、まず、ベイズ因子を基にモデルの比較・選択を行い、その後で、選択されたモデルの効果量などを報告するという順序で進めるのが一般的です(Faulkenberry, T. J. , 2025/2026)。
周辺尤度の比を求めてベイズ因子を計算する
では、ベイズ因子のお話に移ります。今回の例は、前回までの例と決定的に異なる点が1つあります。前回までは、推測したいパラメーターはいずれかの分布のパラメーターそのものでした(例えば、正規分布での平均や拡張ベータ分布として表された相関係数など)。しかし、今回推測したオッズ比は、いずれかの分布のパラメーターそのものではなく、ディリクレ分布のパラメーターを基に計算して求めたものです。従って、オッズ比が従う分布の確率密度関数が式として表されておらず、事前分布の密度が求められないので、Savage-Dickey法は簡単には適用できません。
そのため、SMCサンプリングを行い、素直に周辺尤度の比を求めてベイズ因子を計算することにします。帰無仮説H0と対立仮説H1を確認しておきます。
- H0:オッズ比=1
- H1:オッズ比≠1
H0の場合の事前分布が少しややこしいのですが、説明が長くなるので、今回は先にコード全体を見ておき、事前分布や尤度関数の定義などについては後で説明することにします。以下のリスト2をざっと眺めてから、とりあえず実行して、結果を表示してみてください(サンプルファイルの「SMCサンプリングにより周辺尤度の比を求め、ベイズ因子を計算する」というテキストセルの下にコードがあります)。コードの内容については、リスト2の後で詳しく説明します。
import numpy as np
import pymc as pm
from scipy.special import logsumexp
from pytensor.tensor import outer, stack
# データの準備
data = np.array([[20, 10],
[15, 30]])
# 多項分布の合計
total = data.sum()
with pm.Model() as model0: # 帰無モデル
# 行と列が独立なので、個別に事前分布を定義する
# axis=0の確率変数:ディリクレ分布に従う(ベータ分布と等価なので、ベータ分布を使ってもよい)
pw = pm.Dirichlet("pw", a=np.ones(2), shape=2)
# axis=1の確率変数:ディリクレ分布に従う(ベータ分布と等価なので、ベータ分布を使ってもよい)
pp = pm.Dirichlet("pp", a=np.ones(2), shape=2)
# 各セルの確率を表す確率変数
probs_h0 = outer(pp, pw).flatten() # ベクトルの直積で求められる
#probs_h0 = [pp[0]*pw[0], pp[0]*pw[1], pp[1]*pw[0], pp[1]*pw[1]] # この式と同じ
# 尤度関数:多項分布
obs = pm.Multinomial("obs", n=total, p=probs_h0, observed=data.flatten())
# オッズ比: (p11 * p22) / (p12 * p21)
ratio = pm.Deterministic("ratio", (probs_h0[0] * probs_h0[3]) / (probs_h0[1] * probs_h0[2]))
# サンプリング
idata0 = pm.smc.sample_smc(draws=8000, chains=2, random_seed=42, progressbar=False)
with pm.Model() as model1: # 対立モデル
# 事前分布:ディリクレ分布
probs_h1 = pm.Dirichlet("probs", a=np.ones(4), shape=4)
# 尤度関数:多項分布
obs = pm.Multinomial("obs", n=total, p=probs_h1, observed=data.flatten())
# オッズ比: (p11 * p22) / (p12 * p21)
ratio = pm.Deterministic("ratio", (probs_h1[0] * probs_h1[3]) / (probs_h1[1] * probs_h1[2]))
# サンプリング
idata1 = pm.smc.sample_smc(draws=8000, chains=2, random_seed=42, progressbar=False)
# H0とH1の対数周辺尤度(チェーン数の個数だけ求められる)
log_m0_array = [v[-1] for v in idata0.sample_stats.log_marginal_likelihood.values]
log_m1_array = [v[-1] for v in idata1.sample_stats.log_marginal_likelihood.values]
# 周辺尤度の平均の対数
log_m0 = logsumexp(log_m0_array) - np.log(len(log_m0_array))
log_m1 = logsumexp(log_m1_array) - np.log(len(log_m1_array))
# ベイズ因子
log_bf10 = log_m1 - log_m0
bf10 = np.exp(log_bf10)
print(f"BF10: {bf10:.3f}")
# 出力例
# BF10: 21.735
まず、大まかな構造だけ確認しておこう。帰無仮説H0のモデルがmodel0で、対立仮説H1のモデルがmodel1であること、model0では、事前分布としてディリクレ分布を2つ記述していることを確認しておけばよい。model1は、リスト1のコードとほとんど同じ(MCMCではなく、SMCを使っているだけ)。ベイズ因子の求め方は前回までに見てきた方法と全く同じ。なお、サンプルファイルには、model0でディリクレ分布の代わりにベータ分布を使ったコードなどもコメントとして追加してある(結果はほぼ同じ)。
結果はBF10=21.735となります。これは、対立仮説H1の「オッズ比≠1」を支持する強い証拠となっています。実質的に「雨男・雨女がいると雨が降る」という仮説を支持しているものと考えられます。
では、ここからコードを詳細に見ていきましょう。model0の事前分布から始めます。帰無仮説H0は「オッズ比=1」でしたが、これは「人と天気は独立である」ことを表しています。ちょっと回り道になりますが、この「独立」がどういうことなのかを確認しておけば、リスト2のコードは簡単に理解できます。
独立とはどういうことなのか
具体的な値を使って、人と天気が独立である場合を考えてみます。今回の例では、図7の最初の表に示したように、雨の日は全部で35日、晴の日は全部で40日です(axis=0の合計)。また、雨男・雨女は全員で30人、普通の人は全員で45人です(axis=1の合計)。ここを出発点として「独立」の意味を図7の後で確認していきます。
 図7 人と天気が独立である場合の各セルの確率
行方向の合計とか列方向の合計と表現すると、どの合計なのかが分かりにくいので、明確に区別できるように、axis=0(0番目のインデックス=行のインデックスが変わる方向)の合計、axis=1(1番目のインデックス=列のインデックスが変わる方向)の合計のように記してある。独立であるなら、どのセルも同じ割合で確率が「配分」されているはず。オッズ比もちゃんと(0.4× 0.47)× (0.6× 0.53) / ((0.4 × 0.53) × (0.6 × 0.47))=1になっている。
独立とはどういうことなのかを、図7での計算を見ながら順に確認していきましょう。
- 最初の表: 上で見た通り。雨と晴の日数の合計がaxis=0の欄に、雨男・雨女と普通の人の合計がaxis=1の欄に記入されている。
- 2番目の表: 行や列の合計を全体の合計で割って、確率として表す。雨か晴かの全体の割合がaxis=0の欄に、雨男・雨女か普通の人かの全体の割合がaxis=1の欄で求められる(小数点以下2桁まで。以降も同様)。
- 3番目の表: 各セルの確率を求める(1行目)
- 雨男・雨女である確率は全体の0.4。
- 天気と「関係がない」のであれば、雨男・雨女の「雨」と「晴」の割合は全体の天気の割合と同じ → 0.4を0.47と0.53で配分すればよい
- もし、雨男・雨女の場合に「雨」が多いのであれば、0.47よりも多く配分され、「雨」が少ないのであれば、0.47より少なく配分されるはず。
- 4番目の表: 各セルの確率を求める(2行目)
- 普通の人である確率は全体の0.6。
- 天気と「関係がない」のであれば、普通の人の「雨」と「晴」の割合は全体の天気の割合と同じ → 0.6を0.47と0.53で配分すればよい
- もし、普通の人の場合に「雨」が多いのであれば、0.47よりも多く配分され、「雨」が少ないのであれば、0.47より少なく配分されるはず。
つまりは、人と天気に関係がなければ、各セルの確率が理論的にどのような値になるかを求めたわけですが、このことから、逆に独立の意味が理解できると思います。これは、この連載の仮説検定編で独立性の検定を行ったときに求めた期待度数の計算と全く同じ考え方です(期待度数を全体の合計で割って確率として表したのが図7の表です)。
独立な事前分布を表すには
「独立」の意味と、各セルの確率を求める方法が分かったので、帰無仮説H0での事前分布を定義しているコードをリスト2から抜き出して見てみましょう。なお、独立の意味を理解するために見た図7では、各セルの確率は単なる数値でしたが、以下のコードで定義されるpwやppや、後で登場するprobs_h0などは単なる数値ではなく、確率変数であることに注意してください。
with pm.Model() as model0: # 帰無モデル
# 行と列が独立なので、個別に事前分布を定義する
# axis=0の確率変数:ディリクレ分布に従う(ベータ分布と等価なので、ベータ分布を使ってもよい)
pw = pm.Dirichlet("pw", a=np.ones(2), shape=2)
# axis=1の確率変数:ディリクレ分布に従う(ベータ分布と等価なので、ベータ分布を使ってもよい)
pp = pm.Dirichlet("pp", a=np.ones(2), shape=2)
行と列の確率変数は個別のベータ分布に従う。つまり「雨」か「晴」の確率を表す確率変数pwはベータ分布に従い、「雨男・雨女」か「普通の人」の確率を表す確率変数ppも別のベータ分布に従う(後ろに付けたwはweatherの略、pはpersonの略)。ただし、このコードではH1の場合と形式を合わせるために、ベータ分布と等価な2成分のディリクレ分布を使うこととする。ディリクレ分布のパラメーターは(1, 1)とした。
人と天気が独立であれば、4つのセルの確率変数(p1,p2,p3,p4)は図7で見たのと同様に、以下のように比例配分されます。
| 雨 | 晴 | 合計(axis=1) | |
|---|---|---|---|
| 雨男・雨女 | pp[0]*pw[0] | pp[0]*pw[1] | pp[0] |
| 普通の人 | pp[1]*pw[0] | pp[1]*pw[1] | pp[1] |
| 合計(axis=0) | pw[0] | pw[1] | 1 |
p1がpp[0]*pw[0]に当たり、p2がpp[0]*pw[1] に当たる。さらに、p3はpp[1]*pw[0]に、p4はpp[1]*pw[1]に当たる。この表に従って、各セルの確率変数を求めるとよい。
各セルの確率変数を求める方法は図7での計算と全く同じです。これを基に各セルの確率変数を定義するためのコードを書けばいいのですが、ちょっと面倒な感じがしますね。しかし、朗報があります! 各セルの確率変数は、ベクトルの直積を求めるための関数(pytensor.tensorモジュールのouter関数)を使えば一発で求められます。直積とは、全ての成分同士の積です。つまり、
from pytensor.tensor import outer
pmat = outer(pp, pw)
とするだけで、表3の計算ができます。この場合、結果は以下のような2×2の配列になります。
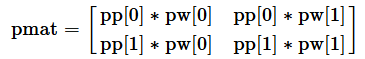
pytensor.tensorモジュールのouter関数の働きは、numpyのouter関数と同様ですが、pytensor.tensor.outer関数は、あくまで計算の方法(計算グラフ)を定義するものです。一方のnumpy.outer関数は数値の計算を行う関数です。なお、PyMCは事前分布などの定義のために、pytensor.tensorモジュールを含むPyTensorライブラリを内部的に利用しています。このことについては、次回、詳しくお話しする予定です。
さらに、多項分布のパラメーターとして指定しやすいように、この配列をflattenメソッドで1行に並べることにします。ここまでをリスト3に続けて書くと、以下のリスト4のようになります(リスト2から抜き出したコードです)。
# 各セルの確率を表す確率変数
probs_h0 = outer(pp, pw).flatten() # ベクトルの直積で求められる
pytensor.tensorモジュールのouter関数を使って直積を求め、各セルの確率を表す確率変数を計算によって求める。結果は2×2の行列となるので、flattenメソッドにより1行に並べる。
尤度関数を定義する
ここまで来れば、後は簡単です。尤度関数として多項分布を使い、パラメーターとして、上で求めたprobs_h0を指定します。続けて、コードを抜き出してみましょう。
# 尤度関数:多項分布
obs = pm.Multinomial("obs", n=total, p=probs_h0, observed=data.flatten())
引数pには各セルの確率を表す確率変数probs_h0を指定する。観測値にもflattenメソッドを使ってdataを1行に並べたものを指定する。
この続きは、前回までに説明した通りなので、これ以上説明することはありません。もう一度、リスト3のコードを眺めてみてください。何をやっているのかがよく分かると思います。
コラム 独立性の検定でのベイズ因子を解析的に求める方法
これまでの分析では、事前分布としてディリクレ分布を、尤度関数として多項分布を利用していました。ところで、表2にもさりげなく記したように、ディリクレ分布は多項分布の共役事前分布となっており、独立性の検定を行うための解析的な方法(Jamil, T. et al., 2017)があります。実は、統計パッケージJASPなどでは、独立性の検定のベイズ因子をその方法で求めています。そのための式はかなり複雑ですが、2×2分割表の場合は以下のような比較的簡単な式になります(それでも複雑ですね)。
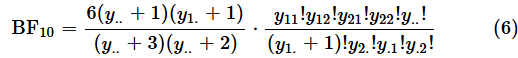
yijはi行j列目の度数で、下付きのピリオドはその位置のインデックスが変わる方向の合計を表します。例えば、y1.はy11+y12で、y..は総合計です。コードは以下の通りです。
import numpy as np
from scipy.special import gammaln
data = np.array([[20, 10],
[15, 30]])
# Jamil et al. (2017)の表記に合わせた各セルの度数
y11, y12 = data[0]
y21, y22 = data[1]
y__ = data.sum() # y..に当たる値:総合計
y1_ = y11 + y12 # y1.に当たる値:_の部分が変わる方向の合計
y2_ = y21 + y22 # y2.に当たる値:_の部分が変わる方向の合計
y_1 = y11 + y21 # y.1に当たる値:_の部分が変わる方向の合計
y_2 = y12 + y22 # y.2に当たる値:_の部分が変わる方向の合計
# log(n!) = gammaln(n+1)を利用。各項に分けて計算
term1 = np.log(6) + np.log(y__ + 1) + np.log(y1_ + 1) - np.log(y__ + 3) - np.log(y__ + 2)
term2 = gammaln(y11 + 1) + gammaln(y12 + 1) + gammaln(y21 + 1) + gammaln(y22 + 1) + gammaln(y__ + 1)
term2 -= (gammaln(y1_ + 2) + gammaln(y2_ + 1) + gammaln(y_1 + 1) + gammaln(y_2 + 1))
log_bf10 = term1 + term2
print(f"BF10:{np.exp(log_bf10):.3f}")
# 出力例
# BF10:21.562
階乗をそのまま計算すると数値が大きくなりすぎるので、対数を取って計算する。階乗の対数はガンマ関数の対数を使って、log(n!) = log Γ(n+1)とすれば求められる。ガンマ関数の対数はscipy.special.gammaln関数を使って求めるとよい。なお、対数を取るので、掛け算は足し算に、割り算は引き算になる。
サンプルファイルには、Jamil, T. et al.(2017)の一般的な式に基づいて計算を行うプログラムも併せて含めてあります。最初に触れたように、背後のモデルにはジョイント多項分布モデル(joint multinomial、今回の例)やポアソン分布モデルなどがあり、計算の方法が異なります。カテゴリカルデータの取り扱いは奥が深いので、興味のある方はぜひ原典(こちらで読めます)などに当たってみてください。それぞれのモデルでの具体的な計算方法も掲載されています。
前回の相関係数に引き続き、今回も「関係」に注目し、カテゴリ間に関係があるかどうかを調べる独立性のベイズ推定/ベイズ検定を行いました。今回のポイントは、事前分布として多変量のベータ分布に相当するディリクレ分布を利用したこと、尤度関数として二項分布を結果が3つ以上に分かれる場合に拡張した多項分布を利用したこと、そして、評価の基準としてオッズ比を使ったことです。
さて、今回までで基本的なベイズ推定/ベイズ検定については一区切りといったところです。しかし、これまで道具として使ってきたPyMCについては「こうすればできる」といった使い方のレベルでしか説明をしてきませんでした。そこで、次回は番外編「PyMC早わかり」と題して、PyMCの基本的な使い方をおさらいするとともに、計算グラフなどの内部的な「謎」についても見ていくこととします。次回もどうぞお楽しみに!
今回使った新出のクラス・関数・メソッド(主なもの)
引数も主なものだけを掲載します。
Dirichlet: ディリクレ分布に従う確率変数を定義するクラス
- モジュール: pymc
- 形式: Dirichlet(name, a)
- 引数:
- name: 確率変数に付ける名前を文字列で指定する。この名前でModelに登録される
- a: 分布の集中度を表すパラメーター
Multinomial: 多項分布に従う確率変数を定義するクラス
- モジュール: pymc
- 形式: Multinomial(name, n, p, observed)
- 引数:
- name: 確率変数に付ける名前を文字列で指定する。この名前でModelに登録される
- n: 度数の合計
- p: 各カテゴリ(セル)の結果が起こる確率
- observed: 観測データ。この引数の指定がない場合は事前分布として扱われ、この引数の指定がある場合は尤度関数として扱われる
outer: 直積を求める関数
- モジュール: pytensor.tensor
- 形式: outer(X, Y)
- 引数:
- X: 直積を求める一方のベクトル
- Y: 直積を求めるもう一方のベクトル
※直積はそれぞれのベクトルの全ての要素同士の積。結果は行列(配列)となる。ただし、この関数は計算した値そのものを求める関数ではなく、計算グラフ(の演算ノード)で定義される計算ルールの結果に当たるTensorVariableクラスのオブジェクトを返す。
参考文献
宮川雅巳, 青木敏. (2018). 分割表の統計解析. 朝倉書店.
Chen, H., Cohen, P., & Chen, S. (2010). How Big is a Big Odds Ratio? Interpreting the Magnitudes of Odds Ratios in Epidemiological Studies. Communications in Statistics - Simulation and Computation, 39, 860 - 864.
Faulkenberry, T. J.(2026). JASPではじめる基礎からのベイズ統計(羽山 博訳). 近代科学社(原著公開2025)
Jamil, T., Ly, A., Morey, R. D., Love, J., Marsman, M., & Wagenmakers, E. J. (2017). Default "Gunel and Dickey" Bayes factors for contingency tables. Behavior research methods, 49(2), 638-652.
Copyright© Digital Advantage Corp. All Rights Reserved.
アイティメディアからのお知らせ
注目のテーマ

 ITmediaはアイティメディア株式会社の登録商標です。