
【Pythonで学ぶデータ分析】ベイズ統計で重回帰分析 ~ 株価のファンダメンタルズ分析を行う:やさしい推測統計(ベイズ統計編)
株価の分析手法には、収益力や成長性など、企業の財務指標などを基に分析するファンダメンタルズ分析と、上昇や下降の傾向などの値動きを基に分析するテクニカル分析があります。今回は、重回帰分析の適用例として、ファンダメンタルズ分析のごく簡単な例を取り上げます。『社会人1年生から学ぶやさしいデータ分析』ベイズ統計編(第11回)です。
この記事は会員限定です。会員登録(無料)すると全てご覧いただけます。
重回帰分析をベイズ統計で行うには? 連載『社会人1年生から学ぶ、やさしいデータ分析』のベイズ統計編、第11回となる今回は、古典的な重回帰分析に代わるベイズ統計での重回帰分析の方法を解説します。といっても、モデルの定義やサンプリングなどの手順はこれまでのベイズ的な手法とほとんど同じです。実際にはどのような回帰式が適切であるかという「モデルの選択」を先に行うべきですが、手順を学ぶ上では、パラメーター(回帰式の係数)の推定を出発点とするのが分かりやすいので、回帰式はあらかじめ決まったものを想定することにします。さらに、回帰式の当てはまりの良さについても検討します。
この連載では、簡単な事例を通してベイズ統計の考え方と分析の進め方を解説します。新しい用語や考え方が幾つも出てきますが、全てを理解しなくても大丈夫です。登場するたびに、分かりやすく丁寧に説明するので、その時点で分からないことがあっても気にせず、先に進んでください。回を追うごとに、少しずつ理解が深まります。どんな考え方で、どんな手順で分析を進めるのか、といった大きな流れを捉えてください。
連載:

この連載では、データをさまざまな角度から分析し、その背後にある有益な情報を取り出す方法を学ぶ『社会人1年生から学ぶ、やさしいデータ分析』シリーズの「記述統計と回帰分析編」「確率分布編」「推測統計(区間推定編・仮説検定編)」に続く「ベイズ統計編」です。
これまでの推測統計を土台に、近年活用が広がっているベイズ統計の考え方と分析手順を、古典的な手法との違いを整理しながら解説します。初めての方でも無理なく理解できるよう具体例を通して進めるとともに、ベイズ的なアプローチの特徴やメリットを実感できる構成とし、「どのように考え、どう使い分けるのか」に重点を置いて解説していきます。
 羽山博
筆者紹介: IT系ライターの傍ら、かつて、非常勤講師として東大で情報・プログラミング関連の授業を、一橋大でAI関連の授業を担当。まだ発展途上のようだが、生成AIへの質問と回答を分野ごとにまとめ、体系的に整理、補足しつつ、さらに個別の学びを促す記述を加えた資料を一貫して作成できるツールが実用レベルで本格的に使えるようになると、書籍の概念が変わるのではないかと思ったりしている。一斉授業だったものが、ユーザーに合った個別指導のできる書籍といったイメージ。そうなると、出版社のビジネスモデルも大きく変わり、私の仕事もなくなってしまいそうだけど、まあ、そのときは、縁側でお茶でもすすりながら、庭の景色を眺めて暮らすことにしようと思う。ウチには縁側も庭もないけど。
重回帰分析により株価のファンダメンタルズ分析を行う
ファンダメンタルズ分析とは、企業の「力」を表すような指標を基に、どの企業に投資すべきかを判断するための分析方法で、中長期的な投資の対象を見つけるために使われます。

一方、テクニカル分析では、直近の値動きや出来高などを短期的な取引の指標として取り扱います。テクニカル分析の手法には移動平均や時系列分析などがありますが、この連載では取り扱いません(機会があればいつか紹介したいと思います。ちなみに、ベイズ統計のお話ではありませんが、移動平均のごく簡単な例についてはこちらで取り上げました)。
ただし、ここで取り扱う事例はあくまで練習問題なので、ファンダメンタルズ分析の指標を「業種」「収益力」「成長性」「割安性」のみに絞ることにします。データも架空のものです。従って、実用的なものではないことをご承知おきください。分析の手順は図1に示したような流れですが、「業種」についてはちょっと工夫が必要なので、図中には示してありません(図中の「…」の部分です)。
 図1 ベイズ統計により重回帰分析を行う
今回の最初の目的は、モデルとして回帰式を定義し、その係数(パラメーター)を推定すること。図中の値は点推定値。さらに、係数と説明変数(ここでは、収益力、成長性、割安性など)の値を基に回帰式の期待値を求め、事後予測サンプルを作成する。観測値(ここでは株価の上昇率)と、得られた予測値を基に決定係数R2を求め、回帰式の当てはまりの良さを見る。
分析に使うサンプルデータに対して、少しばかりの前処理を行います。その後、モデルの記述(回帰式の記述)やサンプリング、パラメーター(回帰式の係数)の推定へと進んでいきます。さらに、推定された係数と説明変数の値を基に回帰式の期待値を求め、事後予測サンプルを作成して回帰式の当てはまりの良さを評価します。
分析に使うデータを用意する
まず、Web上に置いてあるサンプルデータを見てみましょう。サンプルファイルを開いてみてください。Google Colaboratoryの画面が表示されます。最初のコードセルをクリックして[Shift]+[Enter]キーを押せば、サンプルデータが表示されます。
import pandas as pd
# URLの指定
url = "https://raw.githubusercontent.com/Gessys/bayes/main/11.xlsx"
# データを読み込む
df = pd.read_excel(url, sheet_name="Sheet1", skiprows=2)
# データを表示する
df
pandasモジュールのread_excel関数を使ってExcelのファイルから[Sheet1]ワークシートのデータを読み込む。先頭の2行には見出しが入力されているので、skiprows引数により、それらの行を読み飛ばす。
リスト1を実行すると、pandasデータフレームの内容が表示されます(図2)。
 図2 サンプルデータの内容
業種、収益力、成長性、割安性が説明変数で、リターンが目的変数となっている。リターンは、株価の翌年の上昇率(%)。データは50件。途中のデータを省略してあるが、業種にはIT、金融、小売、製造業、不動産の5種類がある。
今回の練習では、それぞれの指標の意味を知る必要はあまりありませんが、一応、箇条書きで説明しておきます。
- 収益力: ROE(Return On Equity:自己資本利益率)と呼ばれる値で、自己資本に対して利益がどれだけ上がったかという指標。
- 成長性: EPS(Earnings Per Share)成長率と呼ばれる値。EPSとは1株当たりの純利益なので、EPS成長率は、1株当たりの純利益が前期からどの程度大きくなったかという指標。
- 割安性: B/P(Book to Price RatioまたはBook to Market Ratio:簿価・時価比率)と呼ばれる値で、1株当たり純資産(BPS)÷株価の値。B/Pが大きい場合は割安、B/Pが小さい場合は株価が割高ということになる。
これらの指標は、業種によって値が異なります。例えば、ROEは大きな工場を持つ製造業などでは小さくなり、大きな設備があまり必要でない保険業などでは大きくなる傾向があります。そのため、説明変数に業種を加えてあります。
続けて、データの前処理に進みます。やるべきことは簡単ですが、本筋から少し外れるので、モデルの記述やサンプリングの方法をすぐに知りたいという方は、前処理の部分は斜め読みで済ませてもらっても構いません。こちらで前処理済みのデータを確認し、回帰式の係数の推定に進んでください。
データの前処理を行う(標準化とダミー変数化)
図2で見た説明変数のうち、収益力、成長性、割安性は数値で表されていますが、それらの値の規模が異なるので、標準化しておきましょう。標準化するには、それぞれの値から平均を引いて、標準偏差で割ればいいですね。
一方、業種は名義尺度のデータ(カテゴリを表す変数)なので、数値として回帰式に含めることはできません。そこで、ダミー変数にします(図3)。
 図3 業種をダミー変数にする
左側が元のデータ、右側がダミー変数化した結果。業種を表す項目を作成し、該当する場合には1を当てはめて、該当しない場合には0を当てはめる。先頭のITという業種については項目を設定していないことに注意。全てが0であれば、ITであることが分かるので、わざわざ項目を設ける必要がない。
ダミー変数を作成するためにはpandasモジュールのget_dummiesという関数が使えます。いちいち自分で1や0を当てはめる必要はありません。
では、前処理を行い、説明変数と目的変数を設定するためのコードを見ておきましょう。
# 数値変数(収益力、成長性、割安性)を標準化する
X_num = df[["収益力", "成長性", "割安性"]]
X_num = (X_num - X_num.mean()) / X_num.std()
# 業種をダミー変数にする
industry = pd.get_dummies(df["業種"], drop_first=True).astype(float)
# 説明変数:数値変数と業種を表すダミー変数をつなぐ
X = pd.concat([X_num, industry], axis=1)
# 目的変数
y = df["リターン"]
# 前処理後のデータを確認する
pd.concat([X, y], axis=1)
pandasデータフレームでも、NumPyと同様、複数のデータを一括して計算できる。meanメソッドで平均を求め、stdメソッドで標準偏差を求めて、標準化を行う。ダミー変数を作成するためのpandas.get_dummies関数で、引数としてdrop_first=Trueを指定すれば、先頭のデータ(この場合は"IT")についての項目が作成されない。標準化されたデータと業種を表すダミー変数をpandas.concat関数でつないで説明変数Xを作成する。
前処理後のデータは図4のようになります。

図4の収益力から金融までが説明変数、リターンが目的変数となります。後は、回帰式の期待値と標準偏差の定義、尤度関数の定義、サンプリングと進むだけです。
pandas.get_dummies関数で作成された項目は、データ中で登場した順ではなく、カテゴリを昇順に並べ替えた順になります。今回の例では、IT以外は、金融、小売、製造業、不動産の順にデータが登場しますが、実際には図4のような順に項目が作られます。
回帰式の係数を推定する ~ モデルの記述とサンプリング
図4のデータを基に、回帰式を立ててみましょう。係数を表す文字として、定数項をα、数値データ(収益力、成長性、割安性)の係数をβ0,β1,β2とします。また、ダミー変数の係数はγ0,γ1,γ2,γ3とします。全て同じ文字を使って添え字だけで区別してもいいのですが、今回は係数の種類が区別できるように別の文字としました。回帰式は以下の通りです。
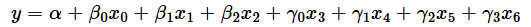
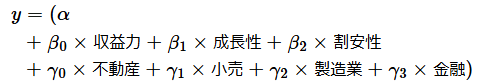
分かりやすくするために、それぞれの項目名を使って表すと以下のようになります。
まずは、定数項を含む8つの係数α,β0,β1,β2,γ0,γ1,γ2,γ3の分布を定義するところからスタートしましょう。
係数の分布を定義する
この例では、説明変数の係数の事前分布が全て正規分布であると仮定しています。それぞれ、リスト3のように書けます。定数項については、大きめの標準偏差を想定しています。
with pm.Model() as model:
# 後で予測に使うことを想定し、"X"を定義しておく
x_pred = pm.Data("X", X)
# 定数項
alpha = pm.Normal("alpha", mu=0, sigma=10)
# 数値変数の係数
beta = pm.Normal("beta", mu=0, sigma=1, shape=X_num.shape[1])
# 業種ダミーの係数
gamma = pm.Normal("gamma", mu=0, sigma=1, shape=industry.shape[1])
x_pred = pm.Data("X", X)は、"X"の値を後から変えられるようにするための記述。この段階では上で作成した説明変数Xを指定している。期待値の定義ではXをそのまま使うのではなく、x_predを使う。そうすれば説明変数"X"をX以外の値に変更してもサンプリングができる(この段階では実感が湧かないと思われるので、予測の段階で後述する)。各係数alpha、beta、gammaは正規分布に従うものとする。X_numで表される数値変数(収益力、成長性、割安性)は3つあるので、betaの定義では、引数にshape=3と指定すればいい。ただし、ここでは汎用性を持たせるためにshape=X_num.shape[1]と指定している。X_numは50行3列なので、そのshape(形)は(50, 3)となる。従って、X_num.shape[1]の値は3。gammaの定義も同様。
目的変数の期待値と標準偏差を定義する
目的変数の期待値muは回帰式として、標準偏差sigmaは分布として、リスト3に続けてリスト4のように書けます。標準偏差は正の値しか取らないので、半正規分布とします。ここでは、広めの分布を想定してsigma=10としています。
# 期待値
mu = (alpha
+ pm.math.dot(x_pred[:, 0:3], beta)
+ pm.math.dot(x_pred[:, 3:], gamma)
)
# 観測値のばらつき(標準偏差)
sigma = pm.HalfNormal("sigma", sigma=10)
期待値muを求めるコードは回帰式をそのまま表したもの。alphaは定数項。pymc.math.dot関数は内積の計算を定義するための関数。x_pred[:, 0:3]は、説明変数の全ての行の0列目から3列目の手前までを表す。つまり、収益力、成長性、割安性を表す数値変数の配列(50行×3列)となる。その配列とbetaの内積を求めることになる。同様に、x_pred[:, 3:]は説明変数の全ての行の3列目以降を表す。こちらはダミー変数の配列。その配列とgammaの内積を求める。なお、観測値のばらつきを表す標準偏差sigmaについては広めの分布を想定した。
pymc.math.dot関数は内積を求める関数ですが、全ての行に対して、各係数と各項目の積和を求めているだけです。もちろん、これは計算グラフの定義なので、実際に計算を行っているわけではなく、計算の方法を定義しているだけです。といっても、分かりにくいかもしれませんね。リスト4の数値変数の部分、つまりpm.math.dot(x_pred[:, 0:3], beta)という部分に則して、簡単に説明しておきます(図5)。ただ、細かな説明が長くなるので、内積の計算方法や配列の要素を参照する方法(x_pred[:, 0:3]の意味)をすでにご存じの方は、尤度関数の定義に進んでいただいても構いません。
 図5 内積の計算により、回帰式の一部(収益力、成長性、割安性の部分)を表す
x_pred[:, 0:3]は、説明変数の0列目から3列目の手前までを表す。つまり、収益力、成長性、割安性のデータを表す50行3列の配列(行列)となっている。行列とベクトルの積の場合、行列の1行目とベクトルの積和が答えの1行目となり(図の上)、行列の2行目とベクトルの積和が答えの2行目となる(図の中央)。3行目(図の下)も同様の計算になる。図には最初の3行だけを示したが、以降の行も同様に計算される(この例では、サンプルサイズが50なので、50行分計算される)。これで回帰式の一部が作成できる。業種を表すダミー変数x_pred[:, 3:](説明変数の3列目以降の列)についても同じ考え方。
期待値muの計算では、定数項αと、図5のようにして求めたβ0×収益力 + β1×成長性 + β2×割安性を加え、さらにγ0×不動産 + γ1×小売 + γ2×製造業 + γ3×金融を加えて回帰式を記述しています。
ここでひとつ注意です。期待値muは、平均値のベイズ推定で見たような単純な平均を表しているものではなく、各係数と説明変数の値によって決まる目的変数yの期待値です。後でもう一度触れますが、サンプルサイズが50なので、muは50個の要素を持つ配列となります。図5のように計算すれば、結果が50行になることからもそのことが分かりますね。
x_pred[:, 0:3]が、説明変数の全ての行の0列目から3列目の手前までを表す、ということも少し分かりにくいかもしれません。これはNumPyで配列の要素を参照する場合の書き方と全く同じです。つまり、x_pred[行の範囲, 列の範囲]という書き方です。このとき、行や列の範囲に:を指定すると、全ての行または全ての列という意味になります。x_pred[:, 0:3]では、行の範囲として:を指定してあるので、全ての行を取り出すことになります。また、列の範囲として指定した0:3は0列目から3列目の手前まで、という意味です。従って、説明変数の50行×3列(収益力、成長性、割安性のデータ)が取り出されるわけです。
一方、ダミー変数の配列を指定するために記述したx_pred[:, 3:]では、行の範囲は:つまり、全ての行です。列の範囲に指定した3:では、3列目からということは指定されていますが、末尾を指定していません。そのような場合は、最後まで(最後の列まで)という意味になります。従って、説明変数の50行×4列(不動産、小売、製造業、金融のデータ)が取り出されます。なお、列の範囲を指定する際に、今回は決まった値(3という値)を指定しましたが、より汎用性を持たせるなら、x_pred[:, 0:3]の代わりにx_pred[:, 0:X_num.shape[1]]と書き、x_pred[:, 3:]の代わりにx_pred[:, X_num.shape[1]:]と書くといいでしょう。
期待値はalpha,beta,gammaなどから計算して求められますが、ここでは特に推定値を確認する必要がないので、pymc.Deterministic関数を使っていません。期待値の推定値を確認したいのであれば、期待値の定義を
mu = pm.Deterministic("mu",
(alpha
+ pm.math.dot(x_pred[:, 0:3], beta)
+ pm.math.dot(x_pred[:, 3:], gamma)
)
)
のようにして、内部的に使われる"mu"といった変数名を付けておきます。その場合、後のリスト6で結果の要約を表示すると、mu[0]~mu[49]の推定値も表示されます。
尤度関数を定義する
続けましょう。尤度関数は以下の通りです。これについては、特に目新しさはないかと思いますが、上で触れたように、muは各企業の観測値に対応する期待値なので、50個の要素を持つ配列であることに注意が必要です。つまり、
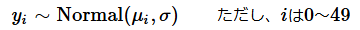
ということになります。各観測値yiの分布が、期待値μi、標準偏差σの正規分布に従うというわけです。平均値の推定のように観測値全体が1つの正規分布に従うモデルではなく、個々の観測値が個別の正規分布に従うモデルであるということです。
# 尤度関数
obs = pm.Normal("obs", mu=mu, sigma=sigma, observed=y, shape=x_pred.shape[0])
観測値yが与えられたときに、それが期待値(平均)mu、標準偏差sigmaの正規分布から得られたものとしたときの尤度を表す。
shape=x_pred.shape[0]は、obsの個数を説明変数の行数に合わせるための指定。これにより、後で新しいデータに差し替えて予測するときも、そのデータの件数に応じた予測値が作成される。
サンプリングを行い、結果の要約を表示する
後はサンプリングを行って結果を表示するだけです。これまでのコードを含めて、コード全体をリスト6に示します。
import pymc as pm
import arviz as az
# 回帰モデル
with pm.Model() as model:
# 後で予測に使うことを想定し、"X"を定義しておく
x_pred = pm.Data("X", X)
# 定数項
alpha = pm.Normal("alpha", mu=0, sigma=10)
# 数値変数の係数
beta = pm.Normal("beta", mu=0, sigma=1, shape=X_num.shape[1])
# 業種ダミーの係数
gamma = pm.Normal("gamma", mu=0, sigma=1, shape=industry.shape[1])
# 期待値
mu = (alpha
+ pm.math.dot(x_pred[:, 0:3], beta)
+ pm.math.dot(x_pred[:, 3:], gamma)
)
# 観測値のばらつき(標準偏差)
sigma = pm.HalfNormal("sigma", sigma=10)
# 尤度関数
obs = pm.Normal("obs", mu=mu, sigma=sigma, observed=y, shape=x_pred.shape[0])
# サンプリング
idata = pm.sample(4000, chains=2, random_seed=42)
# 結果の要約
az.summary(idata)
# サンプリングの手前までは、これまでに見たコード。サンプリングと結果の要約もすでに学んだ知識で理解できるはず。このコードを実行する前には、リスト1とリスト2を実行し、データの読み込みと前処理をしておくこと。
なお、本稿のコードはPyMC 5.28.5、ArviZ 0.22.0で動作を確認している。
リスト6のコードを実行すると、図6のような結果が表示されます。

図6で得られた点推定値を基に回帰式を書くと、以下のようになります。
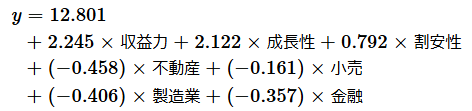
ただし、実際に予測を行う場合には、上の式にそれぞれの値を当てはめるのではなく、事後予測サンプルを作成し、それを基に予測値や予測区間を求めます。ベイズ統計では、パラメーターに不確実性があるものと考えるので、それを反映した予測を行うためです。具体的な方法については後述します。
コラム サンプリング結果のデータ構造を見る
pymc.sample関数の返り値は、arviz.InferenceDataなどの形式になっています。それがどのようなものであるかは、返り値を表示するだけで見られます。リスト6の例であれば、次のコードセルにidataとだけ入力して、実行します(図7)。
 図7 サンプリング結果のデータ構造
ツリーを展開した結果が下の図。サンプリングされた値や観測された目的変数(リターン)の値がどれか分かるように枠で囲んである。各行の右端のハードディスクのようなアイコンをクリックすると、詳細な値が表示される。
pymc.sample関数の返り値には、posterior、sample_stats、observed_data、constant_dataという大きなグループがあり、それらの中に、さまざまなデータが記録されています。各グループの見出しをクリックすれば、その下のデータが表示できます。例えば、posterior-Data variablesの順にツリーを展開していくとサンプリングされた値が表示できます。また、observed_data-Data variablesの順に展開すると、観測された目的変数(リターンの値)が表示されます。
パラメーターの推定ができたので、次に、回帰式の当てはまりの良さについて見ていきましょう。
回帰式の当てはまりの良さを調べる ~ 事後予測サンプルの作成
事後予測サンプルとは、サンプリングによって得られたパラメーター(今回の例では期待値と標準偏差)の推定値を基に、モデルから作成された予測データです。観測値、つまり、リターン(y)の値と事後予測サンプルを比較すれば、モデルの当てはまりの良さが評価できます。以下、幾つかの方法を見ていきましょう。
ベイジアンR2により当てはまりの良さを調べる
回帰式の当てはまりの良さを端的に数値で表すにはベイジアンR2(以下単にR2と表記)の値などが使われます。事後予測サンプルを作成し、R2の値を求めるためのコードは以下のようになります(リスト7)。事後予測サンプルとして実際にどのような値が作成されたのかは、後で見ていくことにします。
import arviz as az
with model:
# 事後予測サンプルを作成する
pm.sample_posterior_predictive(idata, extend_inferencedata=True, random_seed=42)
# 事後予測サンプルの値を取得する(平均を求める)
y_pred = idata.posterior_predictive["obs"].mean(dim=("chain", "draw"))
# R^2を求める
r2 = az.r2_score(y.values, y_pred.values)
print(r2)
# 出力例:
# r2 0.384024
# r2_std 0.000000
pymc.sample_posterior_predictive関数により、事後予測サンプルを作成する。パラメーターは2チェーン×4000個作成されているので、それらを基に、元のデータと同じ個数(50個)の値を含む事後予測サンプルが2×4000個作成される。引数extend_inferencedata=Trueを指定すると、idataの中に事後予測サンプルを含むグループが追加される。y_predは、それらを平均した50個の値。arviz.r2_score関数に観測値yと事後予測サンプルの平均y_predを指定すれば、R2の値が求められる。
出力のr2がR2の値です。r2_stdはR2の標準偏差ですが、ここでは事後予測サンプルの平均(y_pred)からR2を1つだけ求めているので、0になっています。R2の値がどのような意味を持つかは、以下に示すR2を求めるための式を見れば分かります。
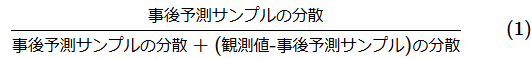
(1)式の意味を大ざっぱに言うと「全体のばらつき(分母)のうち、モデルによって説明できる事後予測サンプルのばらつき(分子)がどの程度であるか」ということです。従って、
- (観測値-事後予測サンプル)の分散が大きい場合:R2の値は小さくなる
→全体のばらつきのうち、モデルによって説明できるばらつきが小さい=モデルの当てはまりが良くない - (観測値-事後予測サンプル)の分散が小さい場合:R2の値は大きくなる(最大値は1)
→全体のばらつきのうち、モデルによって説明できるばらつきが大きい=モデルの当てはまりは良い
と言えます。
(1)式に従い、np.var(y_pred)/(np.var(y_pred)+np.var(y-y_pred))で計算しても、R2の値が求められます。この式は、古典的な重回帰分析の「予測値の分散/(予測値の分散+(観測値-予測値)の分散)」と同じです。なお、平均ではなく事後予測サンプルそのものをarviz.r2_score関数に指定すると、サンプルごとにR2が求められ、パラメーターの不確かさを反映したR2の分布(平均と標準偏差)が得られます。実際には、このような方法が「ベイズ的」で、不確かさを反映したものとなります。サンプルファイルに参考として、そのためのコードを掲載しておきます。
(1)式の分母を見ると、観測値と事後予測サンプルの差が小さければ、分散も小さくなるので、R2は、モデルがどの程度観測値をうまく説明できているかを表す指標として捉えることができます。ただし、リスト7の実行結果として得られた0.384という値が、どの程度モデルの当てはまりの良さを表しているかは、対象となる分野によって異なるので、一概には言えません。例えば、物理学でのデータなど、誤差が小さい場合は0.7以上が必要とされたり、社会科学などの誤差が大きいデータの場合は0.3程度でも有用と見なされたりします。従って、対象となる分野で目安となっている値を参照したり、同じ領域の調査や研究で、それまでに得られた値と比較したりするなどして、評価する必要があります。
コラム 事後予測サンプルを作成した後のデータ構造を見る
リスト7で見たようにpymc.sample_posterior_predictive関数にextend_inferencedata=Trueを指定すると、idataそのものの中に事後予測サンプルが追加されます。リスト7の次のコードセルにidataとだけ入力して実行すれば、それが確認できます(図8)。
 図8 事後予測サンプル作成後のデータ構造
idataの中にposterior_predictiveというグループが追加された。展開してみると、(chain, draw, obs_dim_0)の形式、つまり(2, 4000, 50)の形式で事後予測サンプルが記録されていることが分かる。obs_dim_0はobsの値を記録する配列の次元を表す名前(PyMCによって自動的に付けられた名前)。
なお、extend_inferencedataの既定値はFalseです。その場合、pymc.sample_posterior_predictive関数の返り値から事後予測サンプルが利用できます。このとき、リスト7の該当する部分は以下のように書き換えられます。
with model:
# 事後予測サンプルを作成する
ppc = pm.sample_posterior_predictive(idata, random_seed=42)
# 事後予測サンプルの値を取得する(平均を求める)
y_pred = ppc.posterior_predictive["obs"].mean(dim=("chain", "draw"))
モデルの当てはまりの良さを可視化する
ところで、R2という1つの値だけでモデルを評価するのはずいぶんと一面的ですね。分布の全体像や個々の予測値についても確認しておきたいところです。そこで、観測値の分布と事後予測分布(事後予測サンプルの分布)を重ねて表示してみましょう。
今回の例であれば、正規分布のパラメーターを2チェーン×4000個作成しているので、それと同じ2×4000個の事後予測サンプルが作成されています。1つの事後予測サンプルには、50個の値(各企業のリターンの予測値)が含まれています。「どういうこと?」と首をかしげた方は、上のコラムの図8で図解してあるので、そちらを参照してください。リスト8は、それらの値を利用して事後予測チェックを行うためのコードです。具体的には、事後予測分布、観測値の分布、事後予測分布の平均を重ねて表示します。
import matplotlib.pyplot as plt
# 事後予測分布を表示する
az.plot_ppc(idata, num_pp_samples=1000, random_seed=42)
plt.xlim(-15, 45)
plt.show()
arviz.plot_ppc関数に事後予測サンプルを含むデータを指定するだけでグラフが作成できる。全てのグラフを表示するとあまりにも密になるので、num_pp_samples=1000という指定により、ランダムに選んだ1000個の事後予測分布を表示する。
実行結果は、図9のようになります。
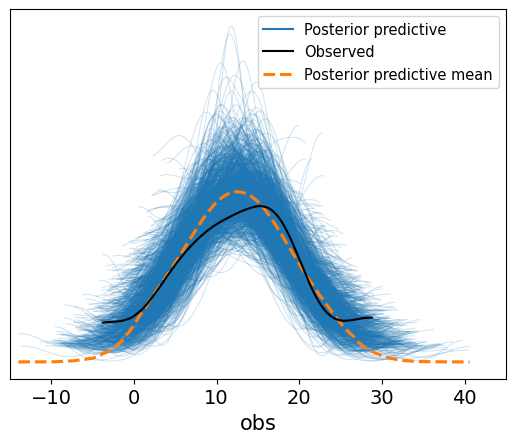 図9 事後予測分布、観測値の分布、事後予測分布の平均を重ねて表示した例
事後予測分布(Posterior predictive)のグラフが1000個、観測値(Observed)のグラフが1つ、事後予測分布の平均(Posterior predictive mean)のグラフが1つ表示されていることが分かる。事後予測分布のグラフと、観測値のグラフはKDE(カーネル密度推定)によりスムージングされたもの。事後予測分布の平均のグラフは、スムージングされた事後予測分布の平均をプロットしたもの(y_predの分布をスムージングしたグラフではない)。
実行結果を見ると、事後予測サンプルの中に観測値がほぼ収まっていることが分かります。つまり、モデルがうまく観測値を説明できる、ということです。ただし、極めて良く説明できるというわけでもないようです。観測値のグラフは山の頂上がやや平らで、事後予測分布の平均の方が中央が高くなっています。予測としては、実際よりも中央に集中したものになっていることがうかがえます。
その原因の一つとして、モデルとして選択した分布が適切でなかったことが考えられます。この例であれば、t分布など、正規分布とは形の異なる分布を試してみることが対策として考えられます。サンプルファイルには、尤度関数としてt分布を使ったコードに書き換えられるように、コメントを加えてあるので、興味のある方は試してみてください(実行すると、R2=0.410となり、多少改善されます。とはいえ、事後予測チェックのグラフはほとんど改善されたようには見えません)。分布の形については、いかんともしがたい部分はありますが、サンプルサイズを増やすと改善される可能性はあります。ただし、都合の良い結果が出るようにデータを恣意的に選んだり、モデルを観測値に合わせすぎたりするのは本末転倒です。特に後者は、いわゆる過学習のような状態になり、未知のデータに対する予測がうまくできなくなる可能性もあるので注意が必要です。
さらに、それ以前の原因として、説明変数が足りない、あるいは適切に選択されていない、ということも挙げられます。最初にも触れたように、本来はあらかじめモデル比較を行い、適切な説明変数を選択しておく必要があります。それについては、次回取り上げるモデルの比較で見ていくこととします。
個々の予測値と観測値とを見比べる
図9では、事後予測サンプル全体の中に観測値がほぼ収まっていることは分かりますが、個々の予測値と観測値が近い値であるかどうかは分かりません。そこで、予測値と観測値を個別に見比べてみましょう。単に散布図を描いたり、折れ線グラフを描くだけなので、コードはサンプルファイルを参照していただくこととして、結果のみ示します。図10は、横軸を事後予測サンプルの平均(y_pred)とし、縦軸を観測値(y)として、y_predとyのペアを散布図として描いたものです。
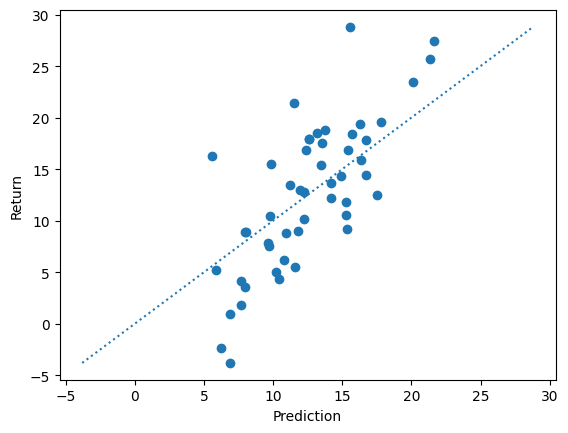 図10 事後予測サンプルの平均と観測値をプロットした散布図の例
対角線に沿って点が並んでいれば、モデルの当てはまりが良いと言える。この例ではある程度対角線に沿ってはいるが、Returnの広がりに対して、Predictionが中央に寄っているので、予測の分散が小さいことが分かる。つまり、観測値よりも控えめな予測になっていることが示唆される。
また、次の図11は、各企業の観測値(y)を折れ線グラフとしてプロットしたものと、事後予測サンプルの平均(y_pred)を折れ線グラフとしてプロットしたものを重ねて表示したグラフです。
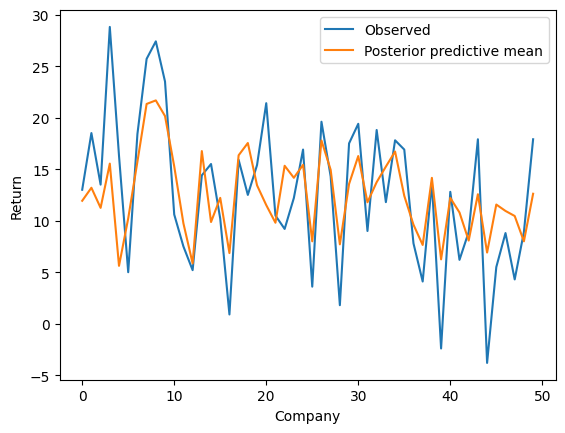 図11 各企業の観測値と事後予測サンプルの平均を折れ線グラフにした例
ブルーのObservedのグラフが観測値、オレンジのPosterior predictive meanのグラフが事後予測サンプルの平均。実際のリターンが大きい企業は事後予測サンプルの平均も大きく、リターンが小さい企業は事後予測サンプルの平均も小さいことが分かる。ただし、事後予測サンプルの方が控えめな値となっている(図10でも示唆された通り)。
図11を見ると、やはり事後予測サンプルの平均が観測値よりも控えめな値になっていることが分かります。説明変数だけでは説明しきれないばらつきがある場合、予測値の平均が全体の平均に寄るのは回帰分析ではよく見られることです。そのため、平均の値だけでリターンの大小を判断せず、予測区間も併せて見ることが大切です。予測の精度を上げるためには、適切な説明変数、適切な分布を選択することが有効です。それにより、事後予測サンプルが観測値に近づく可能性があります。
しかし、上でも触れたように、観測値に近づけることのみを目的にするのは本末転倒です。本来の目的は未知のデータに対する予測が適切にできるようにすることです。そのためには、モデルの選択や予測性能の評価が必要になります(というのは次回のテーマです)。
新しいデータを使ってリターン(株価上昇率)を予測する
ここまで見てきた結果をそのまま未知のデータに対する予測に利用することについては、疑問が残りますが、やり方だけ見ておきましょう。例えば、以下のような指標の値を持つ企業があったものとしましょう。
- 収益力: 15
- 成長性: 10
- 割安性: 0.8
- 業種: 不動産
これらの値を基にリターンの予測値を求めます。手順は以下の通りです。
- 数値データを標準化する
- 業種をダミー変数化する(ここでは手作業で1, 0, 0, 0とする)
- pymc.set_data関数を使って、データをモデル内の説明変数にセットする(モデルの定義時にpymc.Data関数で作成しておいた変数に値をセットする)
- pymc.sample_posterior_predictive関数を使って事後予測サンプルを作成する
手順に従ってコードを書いていきます(リスト9)。
import numpy as np
# データの準備
new_roe = 15
new_eps = 10
new_bp = 0.8
# 標準化し、ダミー変数をセットする
new_X = np.array([
[
(new_roe - df["収益力"].mean()) / df["収益力"].std(),
(new_eps - df["成長性"].mean()) / df["成長性"].std(),
(new_bp - df["割安性"].mean()) / df["割安性"].std(),
1,0,0,0 # 業種ダミー
]
])
with model:
# 新しいデータをセットする
pm.set_data({"X": new_X})
# 事後予測サンプルを作成する
new_pred = pm.sample_posterior_predictive(idata, predictions=True, random_seed=42)
# 事後予測サンプルを取り出す
new_pred_obs = new_pred.predictions["obs"]
# 事後予測サンプルの平均
new_mean = new_pred_obs.mean().item() # 以下.item()はなくても動くが、念のため値だけ取り出す
# 下限と上限
new_lower = new_pred_obs.quantile(0.025).item()
new_upper = new_pred_obs.quantile(0.975).item()
print(f"予測値: {new_mean:.2f}%")
print(f"95%予測区間: {new_lower:.2f}% ~ {new_upper:.2f}%")
# 出力例:
# 予測値: 14.67%
# 95%予測区間: 4.01% ~ 25.21%
new_Xが予測に使う新しいデータ。複数のデータでも構わないので、行×列で表される二次元の配列とする。ただし、ここではデータは1つだけなので、1行×7列になっている。標準化の方法は見ての通り(それぞれの値から平均を引いて標準偏差で割る)。そのデータを説明変数とするために、pm.set_data({"X": new_X})で、"X"という変数にnew_Xの値をセットする。事後予測サンプルは、すでに見たpm.sample_posterior_predictive関数で作成できる。このとき、predictions=Trueを指定すれば、結果がpredictionsというグループに格納される。
新しいデータをセットするところが、初めて見るコードですね。モデルの定義時にx_pred = pm.Data("X", X)と定義したことを思い出してください。"X"という変数名で、説明変数Xに差し替えられる「入れ物」を作成した、というイメージです。pm.set_data({"X": new_X})では、説明変数Xに代えてnew_Xを新しい値としたわけです。引数には、モデル内部で利用される変数名の"X"と、新しい値を辞書型データとして指定します。
後は、pm.sample_posterior_predictive関数を使って、事後予測サンプルを作成し、平均や、95%の値が含まれる範囲を求めるだけです。作成された事後予測サンプルは、predictionsというグループの"obs"という変数名で参照できます。取り出されたデータ(new_pred_obs)はDataArrayと呼ばれる型で、平均を求めるmeanやパーセンタイル値を求めるquantileなどのメソッドが使えます。quantileメソッドでは、例えば、引数に0.025を指定すると、全ての値を昇順に並べたときに先頭から2.5%の位置にある値が求められます。また、0.975であれば、先頭から97.5%の位置にある値が求められます。従って、それらの値を求めれば、全体の95%の値が含まれる区間を知ることができるというわけです。
結果の方は、平均のリターンが14.67%となりました。予測区間は4.01~25.21%です。おおむね利益が出そうではありますが、あまり大きなリターンが得られない可能性もありますね。もちろん、ここで見たモデルそのものの予測性能には疑問符が付くので、あまり信用はできませんが、このようにして判断のための材料が得られるというわけです(実際に、その企業に投資するかどうかは、自己責任で、ですね)。統計学は「何らかの答えを得るためのもの」というイメージを持たれていることも多いようですが、あくまで、得られるのは唯一無二の答えではなく、判断のための材料やさらなる分析のための手がかりです。それは古典的な統計でもベイズ統計でも同じですが、不確実性を反映したベイズ統計の方がよりそのことを直接的に語っているものと思います。
今回は、重回帰分析のために、回帰式を立て、パラメーターをベイズ推定するとともに、事後予測サンプルを作成し、モデルの当てはまりの良さ(モデルが観測値をどの程度よく説明できるか)について見てきました。ただし、本文中でも何度か触れましたが、それ以前にどのようなモデルが適切なのかを選択しておく必要があります。その上で予測に役立てるというのが本来の形です。
次回は、そのためのモデルの選択と予測性能の評価について見ていきます。次回もどうぞお楽しみに!
今回使った新出のクラス・関数・メソッド(主なもの)
引数も主なものだけを掲載します。引数に「=値」と書かれたもの(例:drop_first=False)は既定値を表します。
get_dummies: 名義尺度のデータを基にダミー変数を作成する関数
- モジュール: pandas
- 形式: pandas.get_dummies(data, drop_first=False)
- 引数:
- data: ダミー変数化したいデータ(リストやNumPyの配列、pandasデータフレームなど)
- drop_first: Trueの場合、先頭のカテゴリに対するダミー変数の項目を作成しない
- 返り値: ダミー変数化されたpandasデータフレーム
Data: モデル内にデータを登録するための関数
- モジュール: pymc
- 形式: pymc.Data(name, value)
- 引数:
- name: 内部的に使われる変数の名前
- value: 変数の初期値
- 返り値: valueで指定されたデータを保持するシンボル(TensorSharedVariable型のデータ)
※set_data関数を使って変数の値を変更し、モデルを適用するために使われる。
set_data: モデル内のデータの値を変更するための関数
- モジュール: pymc
- 形式: pymc.set_data(new_data)
- 引数:
- new_data: 変数名と値を辞書型のデータとして指定する
dot: 内積を求める計算グラフを作成する関数
- モジュール: pymc.math
- 形式: pymc.math.dot(l, r)
- 引数:
- l: 配列またはベクトル。左側の項
- r: 配列またはベクトル。右側の項
- 返り値: 内積の計算結果を表すシンボル(TensorVariable型のデータ)
sample_posterior_predictive: 事後予測分布のサンプルを作成する関数
- モジュール:pymc
- 形式: pymc.sample_posterior_predictive(trace, extend_inferencedata=False, predictions=False, random_seed=None)
- 引数:
- trace: MCMCサンプリングによって得られたサンプリング結果を指定する
- extend_inferencedata: 以下の値を指定する
- True: 事後予測サンプルがtraceに追加される
- False(デフォルト): 事後予測サンプルが返り値として返される
- predictions: 以下の値を指定する
- True: 事後予測サンプルが返り値のpredictionsグループに追加される
- False(デフォルト): 事後予測サンプルが返り値のposterior_predictiveグループに追加される
- random_seed: 乱数の初期設定のための値。None(デフォルト)の場合、毎回異なる乱数が作られる
- 返り値: 事後予測分布のサンプルなどを格納したInferenceData型などのデータ
r2_score: ベイジアンR2を求める関数
- モジュール: arviz
- 形式: arviz.r2_score(y_true, y_pred)
- 引数:
- y_true: 観測値
- y_pred: 事後予測サンプルの平均
- 返り値: R2の値と、R2の標準偏差
plot_ppc: 事後予測チェックのためのグラフを描画する
- モジュール: arviz
- 形式: arviz.plot_ppc(data, num_pp_samples, random_seed=None)
- 引数:
- data: 事後予測サンプルを含むデータ
- num_pp_samples: グラフ化するサンプルの個数
- random_seed: 乱数の初期設定のための値。None(デフォルト)の場合、毎回異なる乱数が作られる
quantile: パーセンタイル値を求めるメソッド
- モジュール: xarray
- クラス: DataArray
- 形式: DataArray.quantile(q)
- 引数:
- q: パーセンタイル値を求めたい分位数を0~1までの値で指定する
Copyright© Digital Advantage Corp. All Rights Reserved.
アイティメディアからのお知らせ




注目のテーマ






 ITmediaはアイティメディア株式会社の登録商標です。